
La plupart des agents IA échouent en production parce qu’ils sont construits à l’envers
le système d’agents échoue sérieusement en production, ce n’était pas dramatique. Il n’y a pas eu d’accident. Aucun message d’erreur. Le système a continué à fonctionner et à produire des résultats qui semblaient raisonnables jusqu’à ce que quelqu’un les lise suffisamment attentivement pour remarquer que quelque chose n’allait pas.
Lorsque nous avons décidé de nous pencher sur la question, il nous a fallu deux jours de débogage pour comprendre ce qui se passait. Assez drôle, le modèle n’était pas hallucinant et les outils d’entrée-sortie fournissaient les bons résultats.
Le problème, lorsque nous l’avons finalement trouvé, était architectural. Le modèle et les outils ont été configurés correctement, mais l’idée était que le raisonnement relierait le tout, ce qui, comme vous pouvez l’imaginer, a évidemment échoué.
Il s’avère que le raisonnement ne fait pas ce genre de chose.
C’est à cette expérience que je reviens sans cesse lorsque je réfléchis aux raisons pour lesquelles tant d’agents d’IA travaillant dans des démos ne survivent pas vraiment à une utilisation dans le monde réel.
Ce n’est pas un problème de capacité.
C’est une question architecturale.
Et si vous avez lu mon article précédent ici sur TDS, Pourquoi les ingénieurs en IA vont au-delà de LangChain vers des architectures d’agents natifs, le modèle devrait vous sembler familier : des systèmes construits de haut en bas, de l’objectif aux outils en passant par le modèle, avec l’hypothèse discrète qu’un comportement intelligent comble les lacunes.
Cette hypothèse est ce que signifie « construit à l’envers ». Et c’est plus courant que la plupart des équipes ne le pensent jusqu’à ce que quelque chose se brise.
Les agents ne sont pas des entités. Ce sont des systèmes.
Un agent IA de production n’est pas une simple chose intelligente.
Il existe plutôt un ensemble d’éléments en interaction avec différents responsabilités, modes de défaillance et niveaux d’observabilité.
Le LLM est l’un de ces composants, pas l’ensemble du système. Juste un morceau.
Cela peut paraître évident lorsque vous le dites à voix haute. Mais le cadre de « l’agent autonome » qui a dominé 2023 et la majeure partie de 2024 a continué à attirer les ingénieurs vers un modèle mental différent : une entité, une boucle de raisonnement, tout est géré par le modèle.
Tout ce dont vous avez besoin, ce sont des outils, une bonne invite système et l’espoir que tout se mettra en place.
En revanche, les ingénieurs qui ont livré de véritables produits basés sur l’IA décrivent rarement leurs systèmes de cette façon. Ce qu’ils décrivent réellement ressemble beaucoup plus à une architecture de systèmes distribués.
Non pas parce qu’ils ont lu un livre sur les modèles de conception, mais parce qu’ils se sont suffisamment brûlés pour commencer à prendre plus au sérieux la structure de leur flux de travail.
La construction descendante, en commençant par « que doit faire cet agent » et en remontant vers les outils et les invites, est rapide à démarrer.
C’est aussi ainsi que vous vous retrouvez avec un système dans lequel le modèle est trop responsable et où rien n’est déboguable individuellement.
L’architecture a été décidée par l’objectif et non par les exigences techniques.
C’est la partie inverse.
Alors, qu’est-ce qui entre réellement dans un système de production ?
La version abstraite est facile à suivre. Voici à quoi cela ressemble réellement.
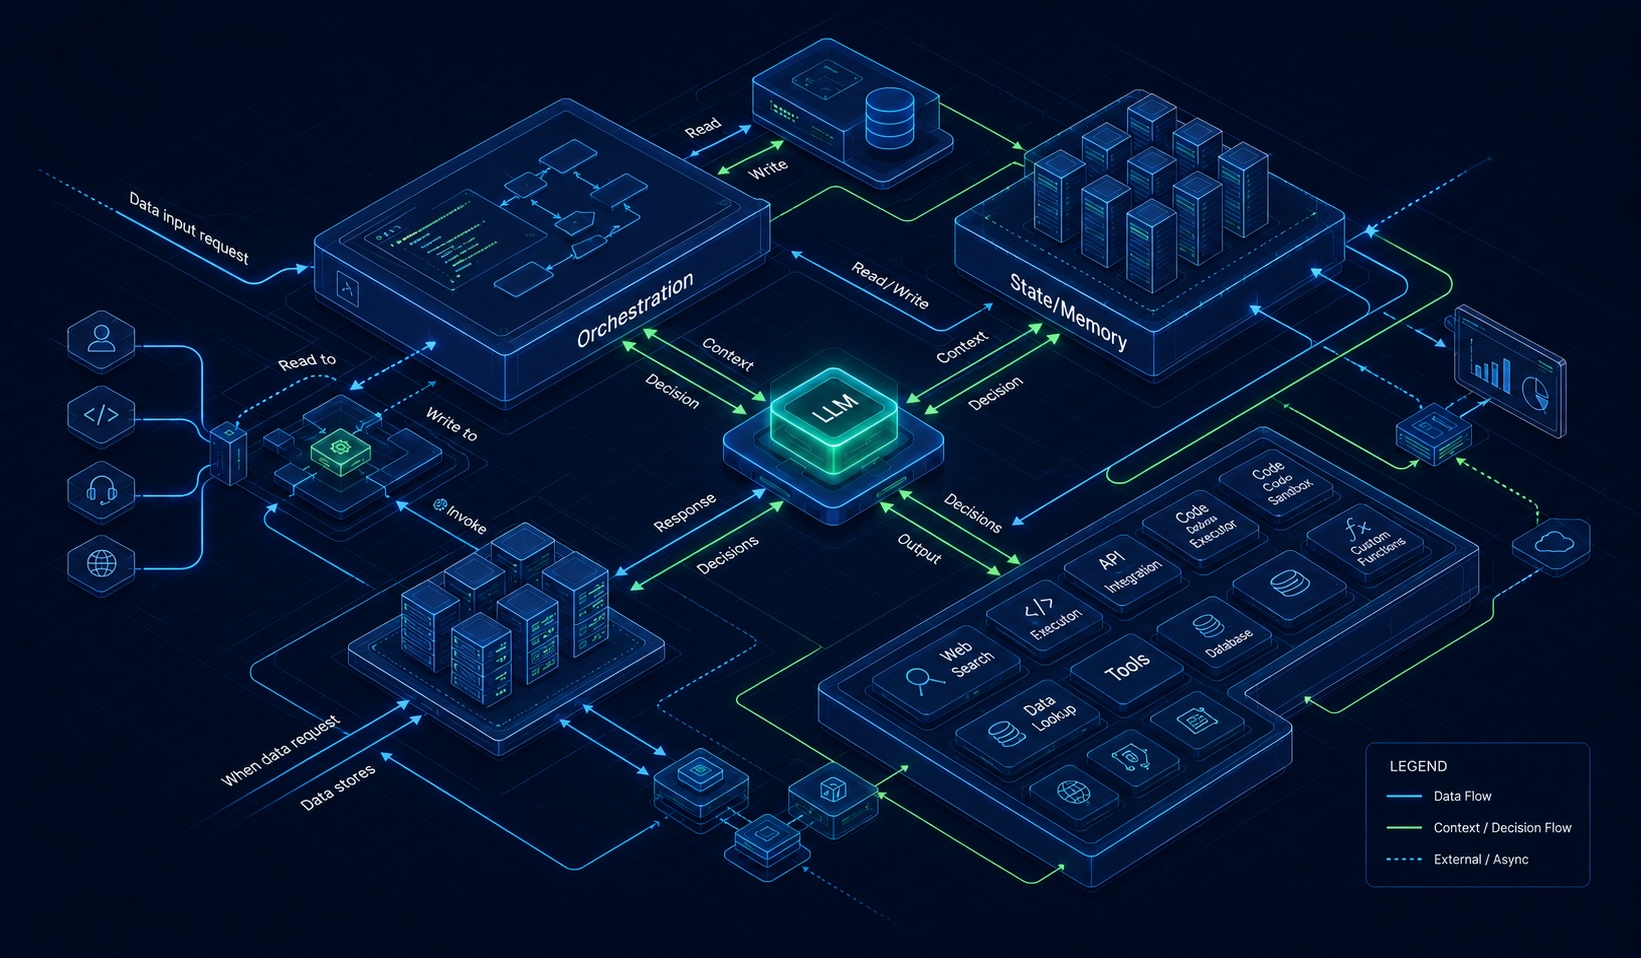
Chaque système d’IA de production que j’ai vu et qui fonctionne proprement a quelque chose comme un couche de décisionque l’équipe l’ait nommé ainsi ou non. C’est la partie où le modèle vit et fait son véritable travail.
L’instinct est de tout placer dans cette couche : analyser les requêtes, gérer la mémoire, gérer les tentatives, résoudre les pannes des outils.
Ce n’est pas grave si vous travaillez dans un notebook Jupyter. En production, sous charge, avec de vrais utilisateurs, cela devient la partie de votre système où tout est la faute de tout le monde, et la plupart du temps, rien ne peut être débogué.
La couche décisionnelle doit bien faire une chose, à savoir décider quoi faire ensuite, compte tenu d’un certain contexte qui y est déjà préparé.
C’est tout le travail.
Qui prépare le contexte ? Quelque chose d’autre. Qui agit sur la décision ? Et autre chose aussi.
Cet « autre chose » est la couche d’orchestration, et dans la plupart des systèmes bien construits, il ne s’agit en réalité que de code : conditions, exécuteurs asynchrones, gestion des nouvelles tentatives, routage de file d’attente, peut-être même une machine à états en fonction de l’implication du flux de travail.

De nombreuses équipes optent pour des frameworks ici parce que le code d’orchestration nue semble trop simple, comme s’il était sûrement censé y avoir plus d’infrastructure.
Il n’y en a généralement pas.
Moins cette couche contient de magie, plus vite vous trouverez les bugs lorsqu’ils apparaissent. Et ils apparaîtront.
Par expérience, j’ai appris cela à mes dépens sur un projet où l’orchestration vivait dans le modèle d’exécution d’un framework. Quelque chose réessayait d’appeler l’outil d’une manière qui corrompait l’état en aval.
Nous avons passé deux jours à trouver le problème. Deux jours pour un bug qui aurait pu être résolu en un rien de temps si la logique de nouvelle tentative avait été trois lignes de Python que j’avais écrites moi-même.
Cela nous amène à la couche d’outils et d’exécution, où se déroule toute la communication.
Maintenant, le outils et couche d’exécution C’est là que les choses parlent au monde extérieur. Cette couche n’a généralement qu’une seule tâche : prendre une entrée bien définie et produire ensuite une sortie prévisible.
Mais l’échec que je n’arrêtais pas de constater et de répéter, honnêtement, était celui des outils qui essayaient d’être utiles en faisant plus d’une chose. Une fonction unique qui appelle une API, met à jour un cache et effectue d’autres tâches.
Dans une configuration comme celle-là, quand ça casse, on ne sait pas où. Même lorsque vous essayez de remplacer l’API, vous démêlez une logique qui n’aurait pas dû l’être en premier lieu.
Mémoire et état C’est là que je pousserais le plus fort, car c’est là que la plupart des équipes sont le moins préparées.
La plupart des équipes considèrent la mémoire comme « ce que le modèle sait ». La question la plus importante est de savoir ce que système sait et si ces connaissances sont actuelles.
Je me souviens d’un jour où il m’a fallu un après-midi pour déboguer ce qui semblait être une simple « hallucination de modèle ». Le modèle faisait toujours référence aux préférences de l’utilisateur, qui avaient cependant été mises à jour il y a vingt minutes.
Ce n’est pas un problème de modèle.
C’est un problème de système.
Et c’est étonnamment courant.
Dans les systèmes multi-agents, en particulier, l’état partagé est le lieu où se produisent des défaillances subtiles. Un agent met à jour quelque chose. Les autres ne le savent pas.
Tout le monde avance avec confiance dans des directions légèrement différentes. Le résultat semble presque correct, ce qui est presque pire que de paraître faux.
Et puis il y a évaluation et observabilitéque presque tout le monde repousse toujours jusqu’à ce que quelque chose se passe mal. J’en suis également coupable.
La différence que je garde à l’esprit est que la journalisation vous indique ce qui s’est passé. L’observabilité vous dit si ce qui s’est passé était correct. Dans un système déterministe, c’est presque la même chose.
Dans un système d’IA, ce n’est pas le cas. Vous devez être en mesure de suivre la demande spécifique du début à la fin, y compris les informations que le modèle a dû prendre en compte, la décision qu’il a prise, l’appel d’API externe qu’il a invoqué et la manière dont il a réagi à sa réponse.
Le construire de la bonne manière
Cela commence par une approche descendante : je veux qu’un agent fasse X, donc je vais lui donner les outils, une invite système intéressante, et si le modèle est suffisamment intelligent, tout ira bien.
Et c’est exactement ce que les gens utilisent pour fabriquer des prototypes, et pourquoi ne le feraient-ils pas ? Ils n’ont pas tort.
Mais voici le problème : le problème est qu’elle traite l’architecture comme une conséquence de l’objectif plutôt que comme quelque chose que vous concevez délibérément.
Ensuite, le système grandit. Vous savez, plus d’outils, plus de flux de travail, plus de cas extrêmes, plus d’utilisateurs, et tout à coup, il n’y a plus de véritable fondation derrière tout cela.
La démarche ascendante prend plus de temps, mais elle est beaucoup plus confortable.
Vous commencez par les éléments de base et vous vous assurez qu’ils fonctionnent réellement. Ensuite, vous déterminez ce que chaque partie doit communiquer, quelles données elle possède et de quoi elle est responsable.
Finalement, le système prend forme naturellement à partir de l’interaction de ses parties.
Il ne s’agit pas d’un argument selon lequel « les vrais ingénieurs construisent tout à partir de zéro ». En fait, il ne s’agit même pas d’une question d’outillage. Il s’agit du modèle mental avec lequel vous construisez.
J’ai vu des ingénieurs utiliser des frameworks sophistiqués et créer des systèmes propres parce qu’ils comprenaient ce que chaque couche devait faire.
J’ai également vu des ingénieurs écrire du Python Vanilla et créer un désordre impossible à déboguer parce qu’ils pensaient encore en termes de « l’agent décide de tout ». Les outils découlent du modèle que vous avez en tête, et non l’inverse.
Le système multi-agent le plus robuste avec lequel j’ai eu l’occasion de travailler en étroite collaboration ne possédait quasiment aucune infrastructure spécifique à l’IA. Quand j’ai vu le dépôt pour la première fois, j’ai honnêtement supposé que je regardais la mauvaise base de code.
Une file d’attente de messages, des processus de travail avec des portées distinctes, un stockage d’état partagé avec des contrats de lecture/écriture explicites et un coordinateur prenant les décisions de routage.
Les requêtes sur le modèle de langage ont été effectuées par les travailleurs eux-mêmes, chacun recevant un ensemble de contexte créé en amont par un processus différent.
Au total, le tout représentait environ un millier de lignes de Python. J’ai vu des agents de démonstration avec plus de code que cela. Chaque pièce était traçable.
Lorsque quelque chose se comportait de manière inattendue, nous trouvions généralement le problème en moins d’une heure, car il n’y avait aucune magie à résoudre. Codez simplement avec un chemin clair à travers.
Ce système a été construit de bas en haut. L’objectif était défini, mais l’architecture n’en découlait pas. Les composants ont d’abord été conçus, évalués individuellement, puis composés afin d’implémenter la fonctionnalité souhaitée. C’est ce dernier aspect qui est le plus important, pas le premier.
Où je pense que ça va
Pour autant que je sache, la direction dans laquelle nous nous dirigeons s’éloigne lentement des « cadres d’agents » pour se tourner vers une infrastructure appropriée, avec des systèmes d’évaluation, de routage de modèles, de repli et de gestion d’état.
Au moins une partie existe déjà. La majorité reste à venir alors que les gens résolvent des problèmes de production difficiles dans cet espace.
Ce que je constate encore et encore, c’est que les personnes qui construisent les systèmes les plus fiables utilisent rarement les meilleurs modèles. Ce qu’ils ont en revanche, c’est une compréhension claire de tout ce qui se passe à l’intérieur de leurs systèmes.
Le modèle utilisé par un tel système peut être GPT-4, mais il peut tout aussi bien s’agir d’un petit modèle local. Peu importe quand tout le reste fonctionne correctement.
Nous passons du traitement du modèle comme du produit au traitement du système comme du produit. Le modèle compte, mais ce n’est qu’un élément parmi tant d’autres.
La plupart des agents n’échouent pas parce que le modèle n’était pas assez performant. Ils échouent parce que le système autour du modèle a été conçu à l’envers, en partant de ce que l’agent devrait faire et en supposant que l’architecture se réglerait d’elle-même.
Ce n’est pas le cas.
Le construire dans le bon sens, les composants d’abord, le comportement ensuite, est ce qui différencie les systèmes qui résistent de ceux qui semblent impressionnants jusqu’à ce qu’ils ne le soient plus.
Avant de partir !
J’écris davantage sur les véritables décisions d’ingénierie derrière les systèmes d’IA, sur les domaines dans lesquels les abstractions sont utiles, là où elles font mal et ce qu’il faut pour construire de manière fiable.
Tu peux abonnez-vous à ma newsletter si vous en voulez plus.
Connectez-vous avec moi

You may also like

Comment décoder le paramètre de température dans les LLM

