
EmoNet : des transformateurs sensibles au locuteur pour la reconnaissance des émotions – et ce que je construirais différemment en 2026
j’ai soumis mon mémoire de maîtrise sur la reconnaissance des émotions dans la conversation (ERC). Le modèle, ÉmoNeta obtenu un F1 pondéré de 39.18 sur EmoryNLP – compétitif avec le classement public PapersWithCode à l’époque, se situant entre TUCORE-GCN_RoBERTa (39,24) et S+PAGE (39,14), et s’améliorant par rapport à la référence que j’ai choisie, CoMPM, en +1,81 F1.
Deux ans plus tard, je suis revenu pour voir où se trouve actuellement le domaine. Le classement est méconnaissable. Les entrées supérieures ne sont plus des modèles à encodeur uniquement dotés de têtes d’attention intelligentes : elles sont Systèmes basés sur LLaMA-2–7B avec réglage fin LoRA et invites améliorées pour la récupération: InstructERC, CKERC, BiosERC, LaERC-S. Les méthodes sont différentes. Le calcul est différent. La mentalité est différente.
Et pourtant, quand je lis attentivement ces nouveaux articles, les idées de base que j’ai proposées dans EmoNet apparaissent à l’intérieur, juste implémentées à une couche différente de la pile. C’est l’histoire de ce que j’ai construit, de son emplacement et de ce que je construirais maintenant si je recommençais.
Qu’est-ce qu’ERC et pourquoi le texte uniquement est difficile
La reconnaissance des émotions dans la conversation consiste à attribuer une étiquette d’émotion à chaque énoncé dans un dialogue à plusieurs tours. Elle se distingue de l’analyse des sentiments sur des phrases isolées sur un point important : l’émotion d’un énoncé est façonnée par ce qui l’a précédé et par celui qui parle.
Considérez cet échange à partir de l’ensemble de données EmoryNLP (provenant de l’émission télévisée Amis) :
Monique : Wendy, nous avions un accord ! Ouais, tu as promis ! Wendy ! Wendy ! Wendy ! [Mad]
Rachel : Qui était-ce ? [Neutral]
Monique : Wendy a renoncé. Je n’ai pas de serveuse. [Mad]
En isolement, « Qui était-ce ? » est émotionnellement neutre. L’étiquette Neutre n’a de sens que dans le contexte – il se situe entre deux propos de colère d’un locuteur différent et les modèles ERC doivent capturer cette dynamique conversationnelle.
Il y a une deuxième ride : les informations multimodales sont manquantes. Dans une conversation humaine réelle, le ton de la voix, les expressions faciales et le langage corporel véhiculent une énorme part de signal émotionnel. L’ERC en texte uniquement supprime tout cela. Les mêmes mots : « Oh, super. » – peut être sincère ou sarcastique, et le texte seul ne peut souvent pas vous dire lequel.
Cette perte d’informations constitue le défi central. Vous devez extraire l’émotion d’un signal plus bruyant que la référence de qualité humaine.
Le paysage 2024
Lorsque j’ai commencé ma thèse fin 2023, le classement EmoryNLP était dominé par des architectures basées sur des transformateurs avec diverses modifications intelligentes. Un petit tour rapide :
– KET (Zhong et al., 2019) — transformateur enrichi en connaissances avec attention graphique affective, le premier article à intégrer les transformateurs à l’ERC.
– DialogueGCN (Ghosal et al., 2019) — réseau convolutionnel graphique qui a converti les dialogues en problèmes de classification de nœuds.
– RGAT (Ishiwatari et al., 2020) — Attention graphique sensible aux relations avec codage de position relationnelle pour les dépendances du locuteur.
– DialogueXL (Shen et al., 2020) — XLNet adapté avec récurrence d’énoncé et auto-attention du dialogue.
– HiTrans (Li et al., 2020) — transformateur hiérarchique avec vérification du locuteur par paire comme tâche auxiliaire.
– TUCORE-GCN (Lee & Choi, 2021) — graphique de dialogue hétérogène avec BERT sensible au locuteur.
– CoMPM (Lee & Lee, 2021) – contexte de dialogue combiné avec suivi de la mémoire pré-entraîné pour l’orateur.
J’ai choisi CoMPM comme base pour deux raisons. Premièrement, il a explicitement modélisé la mémoire pré-entraînée du locuteur en tant que module distinct – ce qui correspondait à mon intuition selon laquelle OMS est-ce que parler compte autant que quoi ils disent. Deuxièmement, son architecture était suffisamment modulaire pour être étendue sans avoir à réécrire à partir de zéro. L’article de CoMPM a montré que l’ajout d’une mémoire pré-entraînée au modèle contextuel donnait un coup de pouce mesurable – mais l’identité de leur locuteur était toujours local à chaque dialogue. Dès qu’une nouvelle conversation commençait, tout ce que le modèle avait appris sur un locuteur était écarté.
Cela semblait être un problème qui méritait d’être résolu.
Trois contributions, avec intuition
1. Identité globale du locuteur
Le problème. Dans CoMPM et la plupart des travaux antérieurs, les identifiants des locuteurs sont limités à un seul dialogue. Haut-parleur A dans la scène 1 n’a aucun rapport avec Haut-parleur A dans la scène 14, même s’il s’agit de la même personne. Par conséquent, chaque dialogue commence à froid.
L’intuition. Les gens ont des schémas émotionnels caractéristiques. Monica se met en colère à propos de choses spécifiques ; Phoebe est toujours de bonne humeur ; Ross a des crises d’insécurité prévisibles. Si un modèle peut transporter des informations sur ce haut-parleur spécifique à travers les dialogues, il devrait être capable de faire des prédictions mieux calibrées lorsque cet locuteur réapparaît.
La mise en œuvre. Chaque locuteur unique de l’ensemble de données obtient un identifiant stable à l’échelle de l’ensemble de données. La première fois Monique Geller apparaît, on lui attribue une pièce d’identité – disons, ID 7 – qui reste avec elle. À chaque apparition ultérieure – à travers les épisodes, les saisons, les scènes – elle reste ID 7. Le modèle peut désormais apprendre des modèles spécifiques au locuteur qui persistent.
Rétrospectivement, cela semble évident. En 2024, ce n’était pas ainsi que fonctionnaient les modèles de classement.
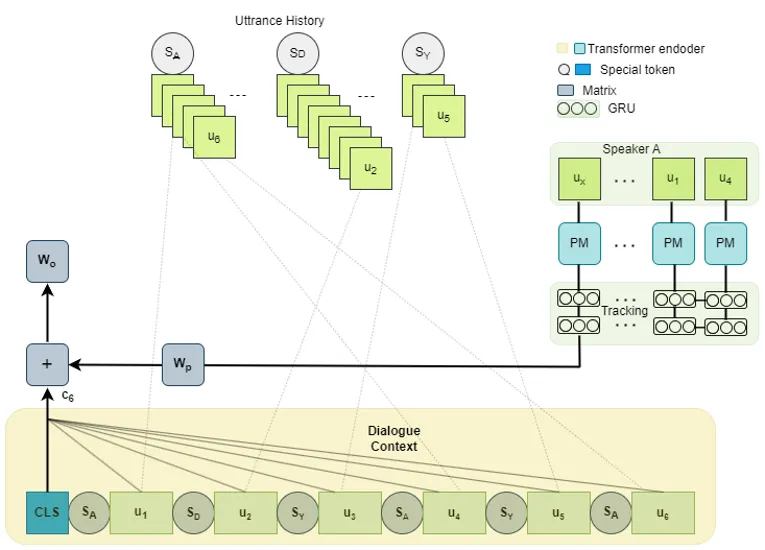
2. Module de comportement du locuteur
Le problème. L’identité globale du locuteur n’est à elle seule qu’une étiquette. Pour le rendre utile, le modèle doit faire quelque chose avec l’historique accumulé de l’orateur. Comment donner à un transformateur l’accès à « tout ce que Monica a dit dans cet ensemble de données », sans faire exploser la fenêtre de contexte ni rendre la formation insoluble ?
L’intuition. Récurrence. Un GRU est un choix naturel pour compresser séquentiellement les énoncés historiques d’un locuteur en une seule représentation de taille fixe. Les déclarations récentes contribuent davantage ; les plus âgés se diluent progressivement. Un configurable fenêtre coulissante limite l’entrée du GRU – par exemple, les N derniers énoncés de ce locuteur – en gardant le calcul et la mémoire prévisibles.
La mise en œuvre. Chaque énoncé est codé indépendamment par un squelette RoBERTa pré-entraîné. Les intégrations résultantes transitent par un GRU unidirectionnel. L’état caché final du GRU — appelez-le « kt » — représente le modèle de comportement du locuteur à l’instant présent. Ceci est projeté dans la même dimension que la sortie du contexte de dialogue et ajouté. Le signal combiné alimente le classificateur final.
L’architecture est structurellement similaire au module de mémoire pré-entraîné de CoMPM, mais avec deux différences clés : le pool d’historique du locuteur est mondial (non local au dialogue actuel), et le GRU modélise explicitement la décroissance temporelle.

3. Perte d’entropie croisée pondérée
Le problème. EmoryNLP est déséquilibré — Neutre est plus nombreux Triste d’environ 4,5:1. La plupart des articles traitent cela avec une augmentation des données ou un sous-échantillonnage. Mais les données conversationnelles sont séquentiel: la suppression ou la duplication d’énoncés déforme le flux émotionnel naturel, ce qui est exactement le signal dont le modèle essaie d’apprendre.
L’intuition. Si vous ne pouvez pas modifier les données en toute sécurité, modifiez la perte. Poids des classes rares plus élevé, donc une seule erreur de classification de Triste coûte plus cher au modèle qu’une seule erreur de classification de Neutre.
La mise en œuvre. Entropie croisée avec poids par classe dérivés de la fréquence de classe inverse, puis normalisés. Rien d’exotique – mais avec l’argument de la séquence conversationnelle comme motivation explicite, cela devient un choix de principe plutôt qu’arbitraire.
Résultats : ce qui a fonctionné et ce qui m’a surpris
Voici le tableau d’ablation de la thèse :

Le résultat qui m’a surpris — et qui, à mon avis, est la partie la plus honnête de ce travail — est la deuxième rangée. L’ajout de Global Speaker ID seul a rendu le modèle considérablement pire (F1 est passé de 37,85 à 29,43). Au début, cela ressemblait à un échec.
Mais ce n’était pas le cas. L’identité globale du locuteur est un capacité – cela donne au modèle la possibilité d’apprendre les modèles de haut-parleurs à longue portée. À elle seule, cette capacité crée un fardeau de représentation que le reste du modèle ne pourrait pas absorber. Une seule fois le Module Comportement du locuteur a été ajouté – donnant au modèle une manière structurée de utiliser les identités globales – la contribution a-t-elle fait surface. Dans la configuration finale, EmoNet avait récupéré et dépassé la ligne de base CoMPM de 1,81 F1.
Voici la leçon que j’ai tirée de l’ablation : une fonctionnalité n’a pas de valeur seule ; il a de la valeur en combinaison avec les machines qui le consomment. Les documents de recherche qui rapportent que « cet ajout nous a donné + X % » cachent souvent des lignes d’ablation où l’ajout à lui seul a aggravé la situation. J’ai choisi de garder cette ligne.

Le modèle complet géré Neutre, Joieet Effrayé Bien. Puissant reste la classe la plus difficile – en partie parce que c’est rare, et en partie parce que Puissant et Joie sont presque impossibles à distinguer dans une conversation textuelle sans signaux acoustiques. Il s’agit d’un problème multimodal se faisant passer pour un problème de texte.
Réflexion (2026) : le domaine a bougé, et devrions-nous aussi
Deux ans plus tard, le classement EmoryNLP est complètement différent. Les principaux systèmes sont désormais :
– InstruireERC (Lei et al., 2023) — reformule l’ERC comme une tâche LLM générative. Il utilise des modèles d’instructions augmentées par récupération et des tâches auxiliaires telles que l’identification du locuteur et la prédiction des émotions pour mieux modéliser les rôles de dialogue et la dynamique émotionnelle.
– CKERC (Fu, 2024) — introduit l’ERC amélioré par le bon sens. Pour chaque énoncé, un LLM génère des annotations de bon sens sur l’intention du locuteur et la réaction probable de l’auditeur, fournissant ainsi un raisonnement social et émotionnel implicite au-delà du contexte de dialogue explicite.
– BiosERC (Xue et al., 2024) – injecte des informations biographiques du locuteur dérivées du LLM dans le processus ERC, permettant au modèle de raisonner non seulement sur le contexte de l’énoncé, mais également sur les traits spécifiques du locuteur.
– LaERC-S (Fu et al., 2025) — réglage des instructions en deux étapes. Étape 1 : équiper le LLM en caractéristiques spécifiques au locuteur. Étape 2 : utiliser ces caractéristiques pendant la tâche ERC elle-même.
Regardez attentivement ces deux derniers.
Informations biographiques des conférenciers de BiosERC est, dans l’esprit, une identité globale du locuteur mise à l’échelle – au lieu d’un identifiant entier, c’est un profil textuel auquel le LLM peut s’occuper. Caractéristiques des enceintes du LaERC-S sont, dans l’esprit, le module Speaker Behaviour – des modèles de haut-parleurs historiques mis à la disposition du modèle – mais intégrés dans le réglage des instructions plutôt que mis en œuvre en tant que GRU distinct.
Les intuitions architecturales ont tenu. La couche de mise en œuvre a changé.
C’est la partie que je trouve vraiment intéressante. Lorsque je travaillais sur EmoNet en 2024, je pensais au paradigme du transformateur-encodeur uniquement : « comment ajouter un autre module à l’architecture ? Les articles de 2024-2025 réfléchissent à l’intérieur du paradigme LLM : « comment puis-je encoder cette idée dans un contexte de réglage ou de récupération d’instructions ? Les idées sont similaires ; les points de levier sont différents.
Si je devais reconstruire EmoNet aujourd’huije ne partirais pas de RoBERTa-large. Je partirais d’un petit LLM open source – LLaMA-3.2-3B, Qwen-2.5-3B ou Phi-3.5 – et j’utiliserais LoRA pour l’affiner sur EmoryNLP, en suivant la famille d’approches InstructERC. L’identité globale du locuteur devient une biographie textuelle du locuteur extraite d’un magasin de vecteurs. Le module Comportement du locuteur devient une invite rapide avec l’histoire émotionnelle la plus récente de l’orateur. La perte pondérée survit presque inchangée : le déséquilibre des classes ne se soucie pas du modèle que vous utilisez.
Le schéma d’architecture serait complètement différent. La dette conceptuelle envers la thèse de 2024 serait visible si vous saviez où chercher.
Cela m’a appris que la dette de recherche a une demi-vie plus longue que ce à quoi je m’attendais : les idées survivent aux changements de paradigme même si leur mise en œuvre ne survit pas.
Où cela me mène
EmoNet est désormais archivé publiquement sous DOI 10.5281/zenodo.20048006 avec la thèse complète, les diapositives de soutenance et l’implémentation de PyTorch sur GitHub. Je travaille actuellement sur le port modernisé – un LLM optimisé par LoRA avec un contexte de haut-parleur basé sur la récupération – en tant que projet de suivi sur lequel j’écrirai bientôt.
Si vous travaillez sur l’IA conversationnelle, la PNL appliquée ou le réglage fin du LLM, je serais intéressé de savoir ce que vous construisez.

You may also like

Comment décoder le paramètre de température dans les LLM

