
Ce sont les leçons que nous avons apprises en cours de route. Ou est-ce ?
ChatGPT est un problème typique de stage d’un mois dans l’espace des données. Dans un certain sens, le problème a été « résolu », mais je ne suis pas sûr que cela signifie ce que je pensais. Pour les praticiens des données et de l’IA, il s’agit désormais d’une question très pratique. De nombreuses équipes font appel à des stagiaires ou à des chercheurs en pointe pour explorer des idées : l’IA est-elle suffisamment performante désormais ? Ces projets concernent-ils uniquement l’artefact final ?
Des stagiaires comme explorateurs
Construire une feuille de route technologique lors d’un démarrage de données à un stade précoce n’est pas si différent d’une carte de jeu vidéo typique :

La feuille de route est bien plus vaste non seulement que ce que vous pouvez faire, mais aussi ce que vous pouvez voir. Si seulement nous pouvions jeter un coup d’œil au-dessus de « l’horizon (du produit) » en envoyant un explorateur pour effacer la carte, nous prendrions alors conscience de ce qui vous attend. une fois sur place (l’explorateur peut mourir, donc l’analogie est bonne jusqu’à un certain point).
Bauplan (qui J’ai co-fondé en 2024) a fait le choix inhabituel (pour sa taille) d’organiser des stages d’été dans des institutions de premier plan (Université Columbia, CMU, Université du Wisconsin-Madison) pour jeter un coup d’œil à l’horizon. Cela a très bien fonctionné jusqu’à présent. Outre un meilleur entonnoir de recrutement, une position communautaire et un certain poids social, les explorations réalisées leur chemin dans notre produitet constitueront des atouts stratégiques au fur et à mesure de la croissance de l’entreprise.
Alors que j’envoie des offres de stage pour l’été 2026, la moitié de mon flux X me dit que je m’y prends mal. Loin d’être un problème hypothétique, à différentes étapes, tailles et contraintes, toutes les équipes data et IA aujourd’hui sont confrontés à la même question : existe-t-il désormais une meilleure façon de réaliser des pointes de recherche avec des agents ? Si oui, qu’est-ce qu’une bonne configuration d’IA testée et facile à adapter ?
Dans l’espoir que notre expérience et notre perspective seront précieuses pour de nombreux praticiens des données, voici notre configuration et les leçons que nous avons tirées d’une véritable pointe de recherche réalisée en association avec ChatGPT.
D’abord, ils sont venus chercher les consultants, et je n’ai pas parlé…
À l’heure où l’IA menace les travailleurs du savoir, les postes subalternes semblent être ceux qui tombent en premier. Pourquoi McKinsey devrait-il embaucher un analyste de l’Ivy League alors qu’un abonnement de 200 $ produit plus de rapports, plus rapidement ? Dernièrement, mon fil semble indiquer que l’IA pourrait également s’en prendre aux chercheurs, les universitaires essayant de s’automatiser – «recherche entièrement autonome de l’idée à l’article » – et les professeurs se demandent s’il faut embaucher plus d’assistants.
Il existe des arguments évidents pour résister à cette tendance. Nous pouvons attaquer le résultatet affirment que la technologie est toujours boguée et que la parité promise « Ivy League » n’est tout simplement pas là. Nous pouvons affirmer que le contrat social est en train d’être brisé : bien sûr, les jeunes chercheurs ont toujours été (dans un certain sens) un « fardeau », mais ce fardeau était à la fois un moyen de payer au suivant et un investissement dans la prochaine génération. Nous pouvons également souligner le potentiel dommages à long terme de remplacer un processus de réflexion bien compris par un nouveau flux de travail non testé.
Bien que tous ces arguments aient du poids, des arguments parallèles pourraient être superficiellement interprétés en faveur de l’invention des voitures ou autre. Il y a toujours un moment et un lieu pour ces débats, mais mon intérêt aujourd’hui est bien plus localisé et personnel : que ressentiriez-vous si je devais-je abandonner mes stagiaires pour un abonnement de 200 $ ?
Donc (un peu comme cette physique expérience que j’ai découverte récemment), j’ai essayé de compresser le mois d’un stagiaire en un week-end avec ChatGPT.
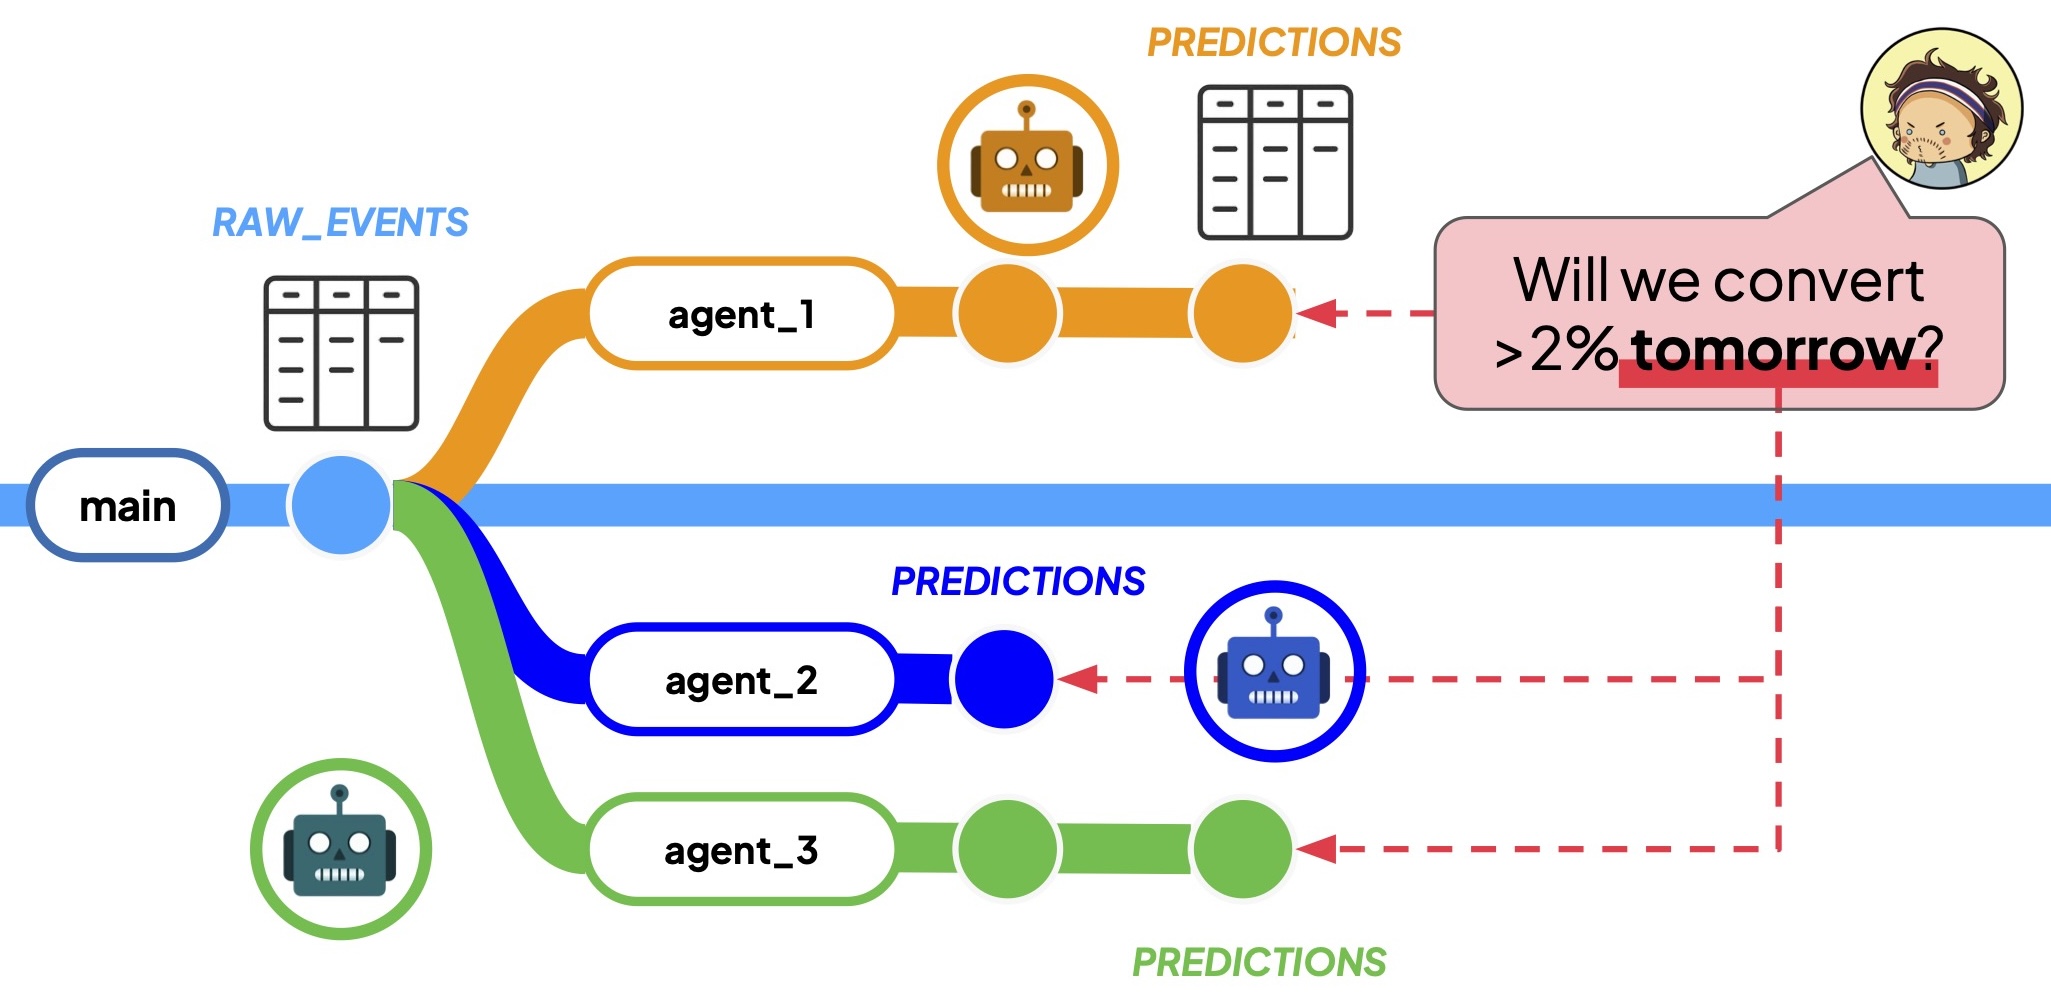
Même si le problème exact n’est pas très important, il peut être utile de définir la portée du stage pour avoir une idée de la situation. taper des choses que font les stagiaires chez Bauplan (n’hésitez pas à sauter !). Bauplan est une plateforme de données à branchement : les agents et les humains peuvent ouvrir des branches de type Git sur leur tableaux. Par conséquent, la même table peut avoir des versions différentes dans différentes branches. Dans notre exemple motivant, Acmé Inc. est un détaillant en ligne dans lequel un essaim d’agents de données est chargé d’effectuer différentes prédictions sur les ventes de demain :

Idéalement, un humain vérifierait le travail, comparerait et contrasterait les résultats, puis fusionnerait les résultats. prédictions tableau comme le représentation canonique des données. Mais que se passe-t-il si quelqu’un pose une question avant que cela n’arrive ?
Les systèmes existants refuseraient tout simplement de répondre, même si cela semble intuitivement inutile : deux agents calculant les revenus mensuels peuvent être en désaccord sur le chiffre exact, mais tous deux conviennent que les revenus ont augmenté de > 10 % d’un trimestre à l’autre. En d’autres termes, même lorsqu’il n’existe pas de version des données convenue à l’échelle du système, nous pourrait répondez toujours à de nombreuses questions intéressantes.
L’objectif de notre stage est alors de construire un prototype d’un tel système. Cela nécessite d’apprendre le branchement, d’acquérir de nouvelles mathématiques, de concevoir une solution au-dessus de Bauplan et de créer à la fois un module texte vers SQL (facile) et un chemin de requête personnalisé (difficile).
La configuration de l’IA
Les Bauplaners ont récemment eu le privilège de voir le seul et unique Wes McKinney faire une démo live de sa configuration, j’ai donc décidé de l’adopter (avec quelques ajustements mineurs) :
- ChatGPT 5.2 pour planifier et décider des stratégies (c’est-à-dire comment concevoir un benchmark mettant en évidence la différence entre les approches d’ingénierie) ;
- Claude Code dans Visual Studio pour faire la boucle de développement proprement dite ;
- Roborev pour examiner localement les commits de manière contradictoire. Propulsées par le Codex, les évaluations mettent en évidence les problèmes potentiels et suggèrent des améliorations ;
- Roborev examine pour apprivoiser la complexité du projet tous les 10 commits environ : ces évaluations adoptent un point de vue architectural et aident à réduire le gonflement.
Le véritable trésor, ce sont les amis que nous nous sommes fait en chemin
Comme je ne supporte pas l’idée que l’IA écrive pour moi (car, pour être honnête, je ne supporte pas non plus l’idée que des stagiaires le fassent), j’ai fait la rédaction finale. moi-même. Comme les stages se terminent généralement par un partage des résultats avec la communauté, j’ai fini par avoir assez de choses pour un ACM. SAO papier, « Interroger tout partout et en même temps».
Selon certains paramètres, le public X avait raison : même en admettant un écart de qualité, j’ai gardé l’IA pendant 48 heures pour faire, disons, 80 % de ce qui aurait pris des semaines. Il est intéressant de noter que le babysitting est d’une autre nature : l’IA est si désireuse de plaire qu’elle finit souvent par « tricher » pour obtenir des résultats superficiels grâce à des raccourcis codés en dur. Bien que de nombreux problèmes de données et d’IA soient superficiellement faciles à vérifier, d’après notre expérience, ils sont également faciles à résoudre : cela est particulièrement vrai lorsque l’interprétation de la configuration expérimentale est nuancée ou que la métrique finale n’est pas simple : vous devriez vérifier trois fois si vos agents IA grimpent une colline ou font simplement semblant.
D’un autre côté, l’IA n’a pas besoin d’être initiée aux modèles de Tarski ou aux excès de vérité, car il suffit de joindre quelques papiers pour démarrer. Les résultats ont également été « tangibles » : j’ai une belle application Web sans avoir à reprendre D3.js (10 ans après ma dernière fois !), et un script de démonstration simulant des pipelines agents et des questions commerciales sur les branches. Si vous croyez (comme moi) que les prototypes battent généralement PowerPoint (ou papiers), il n’y a aucun doute sur la pile IA livrée quelque chose.
Ce qui est plus difficile à mettre en mots, c’est ce qui n’a pas été livré ou, pour le dire plus précisément, ce qui je perdu dans le processus. Malgré tout l’enthousiasme suscité par l’incroyable graphique et le surprenant benchmark, rien de tout cela n’a vraiment produit plus. compréhension. Je ne suis pas plus sage pour avoir suivi le mouvement de recherche : j’ai un peu plus d’intuition qu’avant (par exemple, comment mieux demander de bonnes traductions SQL), mais mes modèles mentaux ont en grande partie la même résolution qu’au début. Travailler avec des stagiaires peut prendre du temps et parfois même être frustrant, mais cela produit toujours de meilleures idées chez eux. et moi-même : en les expliquant et en les encadrant, ils m’expliquent et m’encadrent également en quelque sorte.
Si j’obtiens maintenant des résultats sans grand apprentissage, je me sens mal à l’aise surtout parce qu’il n’est pas clair si cela devrait avoir de l’importance. Je ne veux pas dire si cela compte à l’échelle mondiale et à l’échelle du gros cerveau : bien sûr si nos enfants n’apprennent plus et si nos scientifiques se déchargent de leur réflexion sur le chat, c’est mauvais. Je me concentre maintenant modestement sur ce: est-ce important pour moi, pour mon entreprise, pour mes investisseurs ?
La réponse locale et personnelle – à moins que vous ayez une estime de vous-même très exagérée – est moins claire. Je sais coder et je pourrais probablement encore enseigner un peu de logique mathématique, donc dans un sens, aucun de ces projets n’innove de toute façon : peut-être qu’il n’y a pas tant de choses à apprendre ici (mis à part la faisabilité de tout cela, que bien sûr je soupçonnais en premier lieu), et le malaise que je ressens est l’héritage d’un état d’esprit passé. Oupeut-être qu’il n’y a aucune tâche trop humble pour devenir une version légèrement meilleure de moi-même : faire le travail de base consistant à connecter nos API à un graphique, échouer à compiler DataFusion 13 fois, faire des allers-retours sur la façon de sélectionner des requêtes pour un benchmark convaincant où aucun autre système ne peut exprimer – et encore moins calculer – notre chemin de requête. Je me sens mal à l’aise parce que les projets du monde réel destinés à des personnes du monde réel, pas trop gonflés d’ego, comportent une très grande surface de problèmes qui ne relèvent pas manifestement d’une réflexion sur les principes premiers, ni de détails de mise en œuvre évidents.
je n’ai aucun problème aujourd’hui (demain, nous verrons…) avec la vision simpliste selon laquelle les humains devraient réfléchir et les LLM devraient corriger la syntaxe matplotlib. Mais j’ai du mal avec la grande zone grise entreet la voix intérieure qui murmure cela en traitant tout en tant que détail d’implémentation, mes pensées ne seront bientôt plus vives. Sommes-nous en train de devenir comme ces sociétés de capital-risque qui « correspondent à des modèles » et perdent toutes les nuances ? L’intérêt d’une preuve prouvant un théorème (cependant ressemblant à un extraterrestre, la preuve pourrait en être), ou nous donner un roman compréhension?
L’avenir peut attendre (un peu)
En observant mon décisions (et non mon ressenti) pour l’été 2026 révèle bien les conséquences de cette expérimentation. Bauplan a embauché deux stagiaires (humains), deux jeunes informaticiens talentueux et motivés chargés d’explorer les limites de notre carte produit en ce qui concerne l’optimisation de l’IA de bout en bout (évolution des compétences avec GEPA) et la mise à l’échelle de git-for-data. D’un point de vue pratique, j’ai pris la même décision que j’aurais prise avant ce projet. Cependant, je ne crois pas en être sorti inchangé et indemne : mes sentiments vont à un moment donné se cristalliser dans de nouveaux concepts et influencer ensuite mes décisions.
D’une part, en tant que grand fan du Petit Princeil ne m’échappe pas que c’est le temps perdu sur cette rose qui la rendait importante : passer du temps avec mes stagiaires cet été les rendra (je crois) plus importants, ainsi que notre projet ensemble. D’un autre côté, cela ne reflète que partiellement mon ambiance ces jours-ci. J’ai dû fouiller dans Internet Archive pour récupérer quelque chose dont je me souvenais récemment de 2006 (la logique mathématique n’est pas la seule chose dont je me souviens depuis la vingtaine, apparemment). C’est l’entrée n°1 dans Le « 50 » du mixeur Pire Des choses qui arrivent à la musique »:
#01. LES ENFANTS AUJOURD’HUI
À notre époque, nous n’avions aucun de vos iPod, sonneries et téléchargements sophistiqués. Nous n’avions pas le luxe et la commodité de vos anneaux de scrotum et de vos journaux du World Wide Web. Quand nous avons voulu voler le nouvel album d’URIAH HEEP, nous ne pouvions pas simplement troller les Internets, nous avons dû le faire à l’ancienne : en marchant jusqu’au magasin (en montée, dans les deux sens) et en glissant 12″ de vinyle sous nos pulls (que nous avons dû tricoter nous-mêmes). C’est pour ça que vous, les pleurnichards, n’appréciez pas la vraie valeur de la musique. Ou Uriah Heep. Maintenant, foutez le camp de notre pelouse !
Allons-nous encore apprécier la « vraie valeur des choses » si nous pouvons désormais les « voler » dans le confort de nos ordinateurs portables ?
À bientôt, cowboys agents
Merci à Luca, Colin, Ethan pour leurs commentaires sur une précédente version de cet article.
Si vous voulez devenir stagiaire chez Bauplan et faire des trucs sympas sur les données et l’IA (comme ce ou ce ou ce), j’accepte toujours des candidats humains : contactez-nous !

You may also like

Comment décoder le paramètre de température dans les LLM

