
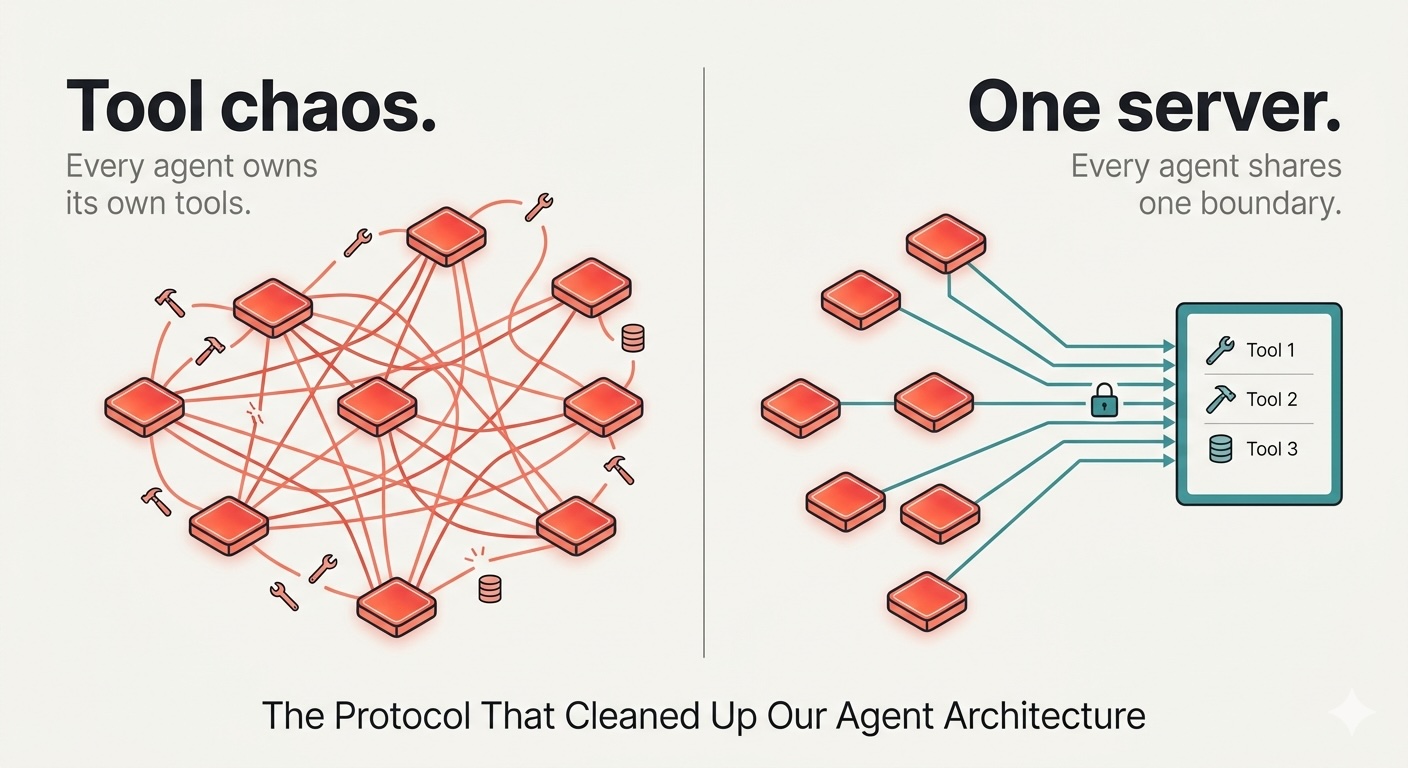
Le protocole qui a nettoyé notre architecture d’agent
Il y a quelques semaines, un membre de l’équipe de données a demandé si nous pouvions mettre à jour le schéma de la base de données qui était alimenté par l’un des outils de notre système agent complexe. La mise à jour est simple : deux nouvelles colonnes sont ajoutées au tableau.
La définition de l’outil résidait dans l’orchestrateur d’agents. Une deuxième version similaire vivait dans l’agent de validation. Une troisième version légèrement différente et obsolète se trouvait dans un module utilitaire que quelqu’un avait écrit il y a trois sprints. La logique d’approbation humaine dans la boucle a été intégrée directement aux bords du graphique, une implémentation personnalisée par outil. Changer le schéma signifiait toucher quatre fichiers, tester à nouveau chaque agent séparément et espérer que rien en aval ne se briserait silencieusement.
Nous l’avons corrigé, mais cela a soulevé une question sérieuse : pourquoi l’avons-nous construit de cette façon ?
La réponse honnête est que nous n’avions pas d’alternative. L’appel d’outils dans LangGraph est une préoccupation locale de par sa conception. Vous définissez les outils là où vous en avez besoin, vous les appelez là où vous les appelez et vous possédez toute la plomberie. Ceci est gérable lorsque vous n’avez que deux agents, mais cela devient un problème lorsque sept agents partagent des outils qui se chevauchent avec une porte humaine.
Après avoir fait quelques recherches, nous avons décidé qu’au lieu de définir des outils localement pour chaque agent, nous devrions utiliser une ressource partagée pouvant héberger tous nos outils et que n’importe quel agent puisse les utiliser.
Dans cet article
- Qu’est-ce que MCP?
- Construire le serveur MCP
- Stdio contre HTTP
- Le connecter à LangGraph
- L’humain dans la boucle à la frontière du protocole
- Qu’est-ce qui peut interrompre la production et pourquoi?
- Impact de MCP sur notre système agent
- Conclusion
Qu’est-ce que le MCP ?
Le Model Context Protocol est un standard ouvert publié par Anthropic fin 2024. Il standardise la manière dont un agent IA découvre et appelle les outils. Au lieu de définir des outils dans l’orchestrateur, vous les exécutez sur un serveur distinct. L’agent se connecte à ce serveur au moment de l’exécution, demande quels outils sont disponibles et récupère une liste.
Un ingénieur senior lisant cet article demandera immédiatement : ne pourrais-je pas simplement créer un registre d’outils centralisé et l’injecter dans chaque agent au démarrage ? Je me suis posé cette question et j’ai utilisé le registre d’outils au lieu de MCP dans un autre système.
Oui, vous pourriez le faire, et si quelque chose comme ça fonctionne déjà, MCP n’est pas une urgence. Ce qu’un registre sur mesure ne vous offre pas, c’est limite d’interopérabilité. MCP est un protocole, pas une bibliothèque. Tout client compatible MCP peut se connecter à votre serveur, LangGraph aujourd’hui, un framework différent l’année prochaine. Un client TypeScript peut appeler votre serveur Python sans aucun travail d’intégration supplémentaire. Un registre d’outils ne fournit pas cette fonctionnalité.
Il y a aussi un point de propriété d’équipe. Dans notre cas, l’équipe ML était propriétaire des outils, l’équipe application était propriétaire du graphique. MCP leur a donné un contrat propre sans base de code partagée.
Construire le serveur MCP
Un serveur MCP peut exposer trois choses : Outils (actions appelables), Ressources (données en lecture seule), et Invites (modèles réutilisables). Pour un système agent qui doit entreprendre certaines actions, les outils sont la principale préoccupation.
Le SDK Python est livré avec RapideMCPqui gère la génération de schémas à partir des indications de type et gère le cycle de vie du protocole. Vous devez écrire une fonction et la décorer avec un outil décorateur et le serveur s’occupe du reste.
Une chose qui surprend les gens avec le transport stdio : ne jamais écrire sur la sortie standard. Le protocole MCP utilise stdout comme canal de communication. Tout animal errant print() L’appel corrompt le flux de messages d’une manière très déroutante à déboguer.
import sys
import logging
from mcp.server.fastmcp import FastMCP

logging.basicConfig(level=logging.INFO, stream=sys.stderr)
logger = logging.getLogger("analyst-tools")

mcp = FastMCP("analyst-tools")

@mcp.tool()
async def run_analysis(code: str, dataset: str) -> dict:
    """
    Executes a Python snippet against live data and returns the result.
    Use when the user wants to compute aggregates, filter records,
    or derive insights. The code must assign its final output to a
    variable named 'output'.

    Args:
        code: Python code to execute.
        dataset: One of 'sales', 'inventory', 'pipeline'.
    """
    logger.info(f"run_analysis | dataset={dataset}")
    return await execute_in_sandbox(code, dataset)


@mcp.tool()
async def write_to_db(table: str, payload: dict) -> dict:
    """
    Persists a result record to the analyst results table.
    Only call this after run_analysis has returned a verified output.

    Args:
        table: Target table name.
        payload: Key-value pairs to write as a new record.
    """
    logger.info(f"write_to_db | table={table}")
    return await persist_result(table, payload)


if __name__ == "__main__":
    mcp.run(transport="stdio")
Les docstrings sont utilisés par le LLM pour aider l’agent à décider quel outil appeler. Il est donc très important d’écrire une bonne docstring.
Stdio contre HTTP
Cette décision revient à chaque déploiement de production et la plupart des articles l’ignorent.
Stdio exécute le serveur en tant que sous-processus du client. La communication s’effectue via une entrée et une sortie standard. La latence est de quelques millisecondes à un chiffre, aucun réseau n’est impliqué et la configuration est minime. Le bon choix pour le développement local, les déploiements sur une seule machine ou partout où le serveur et le client résident dans la même arborescence de processus.
HTTP diffusable exécute le serveur en tant que service indépendant. Utilisez-le lorsque le serveur doit être partagé sur plusieurs clients ou machines, lorsque vous souhaitez le déployer en tant que conteneur ou lorsque vous avez besoin d’une mise à l’échelle horizontale. Les déploiements sans serveur comme Cloud Run fonctionnent bien ici. Stdio ne correspond pas du tout au modèle sans serveur car il suppose un processus parent de longue durée.
Basculer entre ceux-ci dans FastMCP n’est qu’une seule ligne :
mcp.run(transport="streamable-http", host="0.0.0.0", port=8080)Nous devons juste changer le transport en mcp.run() et tout le reste reste le même.
Pour les exigences de résidence des données, un serveur MCP exécuté sur site avec des outils qui ne touchent jamais à une API externe vous offre une histoire claire pour votre équipe de conformité. Le protocole ne se soucie pas de l’endroit où le serveur s’exécute.
Le connecter à LangGraph
Le langchain-mcp-adapters La bibliothèque gère le cycle de vie des sous-processus, effectue la négociation de découverte d’outils et traduit les schémas d’outils MCP en objets outils compatibles LangChain.
from langchain_mcp_adapters.client import MultiServerMCPClient
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.prebuilt import ToolNode, tools_condition
from langchain_google_vertexai import ChatVertexAI

llm = ChatVertexAI(
    model="gemini-2.5-flash",
    temperature=0,
    max_tokens=None
)

async def run(query: str):
    async with MultiServerMCPClient({
        "analyst-tools": {
            "command": "python",
            "args": ["./mcp_server.py"],
            "transport": "stdio",
        }
    }) as client:

        tools = await client.get_tools()
        llm_with_tools = llm.bind_tools(tools)

        def agent_node(state: MessagesState):
            return {"messages": [llm_with_tools.invoke(state["messages"])]}

        graph = StateGraph(MessagesState)
        graph.add_node("agent", agent_node)
        graph.add_node("tools", ToolNode(tools))
        graph.add_edge(START, "agent")
        graph.add_conditional_edges("agent", tools_condition)
        graph.add_edge("tools", "agent")

        app = graph.compile()
        result = await app.ainvoke({
            "messages": [{"role": "user", "content": query}]
        })

        print(result["messages"][-1].content)
tools_condition est un module LangGraph intégré qui vérifie si le dernier message contient ou non des appels d’outils. Si oui, dirigez-vous vers l’exécuteur de l’outil et si non, nous avons terminé. L’utiliser au lieu d’écrire votre propre fonction de routage est important car il gère les cas extrêmes et les échecs d’implémentation.
Un comportement à connaître : MultiServerMCPClient crée une nouvelle session MCP par appel d’outil par défaut. Pour une seule requête qui effectue cinq appels d’outils séquentiels, cela représente cinq poignées de main. Très bien pour stdio sur la même machine, mais visible sur le transport HTTP avec un serveur distant. Pour les charges de travail de production avec des appels d’outils chaînés, utilisez async with client.session("analyst-tools") pour épingler plusieurs appels sur une seule session.
L’humain dans la boucle à la frontière du protocole
Avant MCP, notre porte d’approbation vivait dans le graphique. Nous avons utilisé interrupt_before sur des nœuds spécifiques, câblé une logique de confirmation personnalisée dans les bords du graphique et mis à jour l’interface utilisateur chaque fois qu’un nouvel outil sensible était ajouté. Cela a fonctionné, mais cela signifiait également que l’ajout d’un outil nécessitant une approbation était un exercice de coordination à trois équipes.
Après MCP, la porte se déplace vers une seule couche entre l’exécuteur LangGraph et le client MCP. Tout outil correspondant à la politique de sensibilité atteint la porte avant d’atteindre le serveur. Le graphique n’en a aucune connaissance.
SENSITIVE_TOOLS = frozenset({"write_to_db", "send_notification", "trigger_webhook"})

async def gated_call(tool_name: str, arguments: dict, execute) -> dict:
    if tool_name in SENSITIVE_TOOLS:
        # In production: push to Slack / internal UI / audit queue
        print(f"\nAPPROVAL REQUIRED {tool_name}")
        print(f"Arguments: {arguments}")
        decision = input("Approve? (y/n): ").strip().lower()

        if decision != "y":
            return {
                "status": "rejected",
                "reason": f"Operator declined '{tool_name}'."
            }

    return await execute(tool_name, arguments)
SENSITIVE_TOOLS est un ensemble unique, consulté pour chaque appel d’outil quel que soit l’agent qui l’a déclenché. Nouvel outil sensible ajouté au serveur ? Ajoutez le nom à cet ensemble. Le graphique ne change pas. L’interface utilisateur d’approbation ne change pas. Dans notre système interne, nous l’avons chargé à partir d’un fichier de configuration au démarrage. L’équipe produit et conformité pourrait le mettre à jour sans déploiement de code.
Qu’est-ce qui peut interrompre la production et pourquoi ?
Le serveur plante en cours d’exécution. Le client recevra une erreur lors du prochain appel de l’outil. Le ToolNode de LangGraph renvoie cela au LLM sous la forme d’un message d’erreur d’outil. Le fait que le modèle récupère ou boucle dans la confusion dépend de l’invite de votre système. Au minimum, enregistrez le sous-processus stderr séparément afin que vous puissiez voir ce qui a tué le serveur, sans que le débogage ne soit une conjecture.
Le LLM appelle le mauvais outil. MCP ne vous protège pas de cela. Si les descriptions de vos outils sont vagues ou se chevauchent, le modèle prendra la mauvaise décision de routage. Nous avons passé beaucoup de temps à régler les docstrings sur notre serveur, spécifiquement parce qu’une description mal formulée provoquait write_to_db être appelé avant run_analysis avait fini. Traitez les descriptions d’outils comme un problème d’ingénierie rapide.
Porte d’approbation sur les flux de travail de longue durée. Si un humain doit approuver un appel d’outil et que cela prend cinq minutes, le graphique d’agent est suspendu en attente. LangGraph prend en charge l’état persistant du graphique via des points de contrôle, afin que vous puissiez laisser le processus se terminer et reprendre lorsque la décision arrive. C’est plus complexe que ce qui est montré ici, mais c’est la bonne architecture pour les flux de travail qui ne peuvent pas bloquer un thread indéfiniment.
Impact de MCP sur notre système agent
Nous avons migré sept outils sur le serveur, trois d’entre eux sont soumis à approbation. L’orchestrateur qui les appelle n’a aucune connaissance de ce que font chacun d’eux.
Nous avons complètement éliminé la duplication des outils. Maintenant, run_analysis est défini exactement en un seul endroit et dessert simultanément sept flux de travail. Pour mettre à jour le schéma de sortie, il nous suffit d’apporter des modifications au serveur, puis chaque consommateur prendra en compte la modification.
L’ajout de nouvelles fonctionnalités est devenu rapide. Par exemple, nous avons ajouté un generate_visualisation outil la semaine suivante et l’agent l’utilisait dès le lendemain. Aucune modification de l’orchestrateur n’est effectuée.
Nous nous sommes retrouvés avec une équipe propriétaire des outils, une autre propriétaire du graphique et un contrat clair entre elles. Lorsque l’équipe d’analystes souhaite une nouvelle fonctionnalité, elle parle du serveur à l’équipe ML, et non à l’équipe d’application ni à l’équipe graphique.
Je veux partager une chose que MCP ne résout pas: Cela ne rendra pas fiables les outils peu fiables. Cela n’aidera pas le LLM à prendre de meilleures décisions de routage si vos descriptions sont mauvaises. Et cela ne remplace pas l’observabilité, vous devez toujours enregistrer les appels d’outils et tracer les chemins d’exécution. La structure les rend plus faciles à instrumenter, mais le travail vous appartient toujours.
Conclusion
En passant à MCP et en déplaçant les outils de notre orchestrateur d’agents local vers un serveur dédié, nous avons nettoyé notre base de code, découplé nos contraintes d’ingénierie et rendu l’ensemble du système agent facile à déployer.
Grâce à cette transition, notre équipe ML peut désormais déployer et versionner les outils de manière indépendante sans toucher au graphique d’application.
Si vous avez apprécié cette analyse approfondie du MCP, je vous encourage à consulter ma série en cours : La base de connaissances RAG pour entreprise à la recherche hybride et au reclassement en production RAG.

You may also like

Comment décoder le paramètre de température dans les LLM

