Comment décoder le paramètre de température dans les LLM
La physique : énergie, probabilité et température
qui peut exister dans plusieurs états différents. Chaque état est associé à une énergie. Certains États sont bon marché et nécessitent très peu d’énergie, tandis que d’autres sont chers. Une question fondamentale posée par la physique statistique est d’une simplicité trompeuse :
Compte tenu de tous ces états possibles, quelle est la probabilité que le système occupe chacun d’eux ?
Au début, il peut sembler tentant d’utiliser les énergies elles-mêmes comme probabilités. Mais les énergies ne sont pas des probabilités. Un état peut avoir une énergie de 5, ou -3, ou 127, ce qui ne dit rien sur sa probabilité. Les probabilités obéissent à des règles que les énergies n’obéissent pas : elles ne peuvent jamais être négatives, et ensemble, elles doivent totaliser exactement un.
La solution est d’arrêter complètement de penser aux probabilités. Au lieu de cela, l’énergie de chaque état est d’abord convertie en poids :
L’exponentielle ne produit pas de probabilités. Cela produit une importance relative. Les États à faible énergie reçoivent des poids importants, tandis que les États à haute énergie reçoivent des poids exponentiellement plus petits. A ce stade, rien n’est normalisé ; les chiffres expriment simplement la force avec laquelle chaque État est en concurrence avec les autres.
Transformer ces poids en probabilités est presque trivial. Divisez le poids de chaque état par la somme de tous les poids :
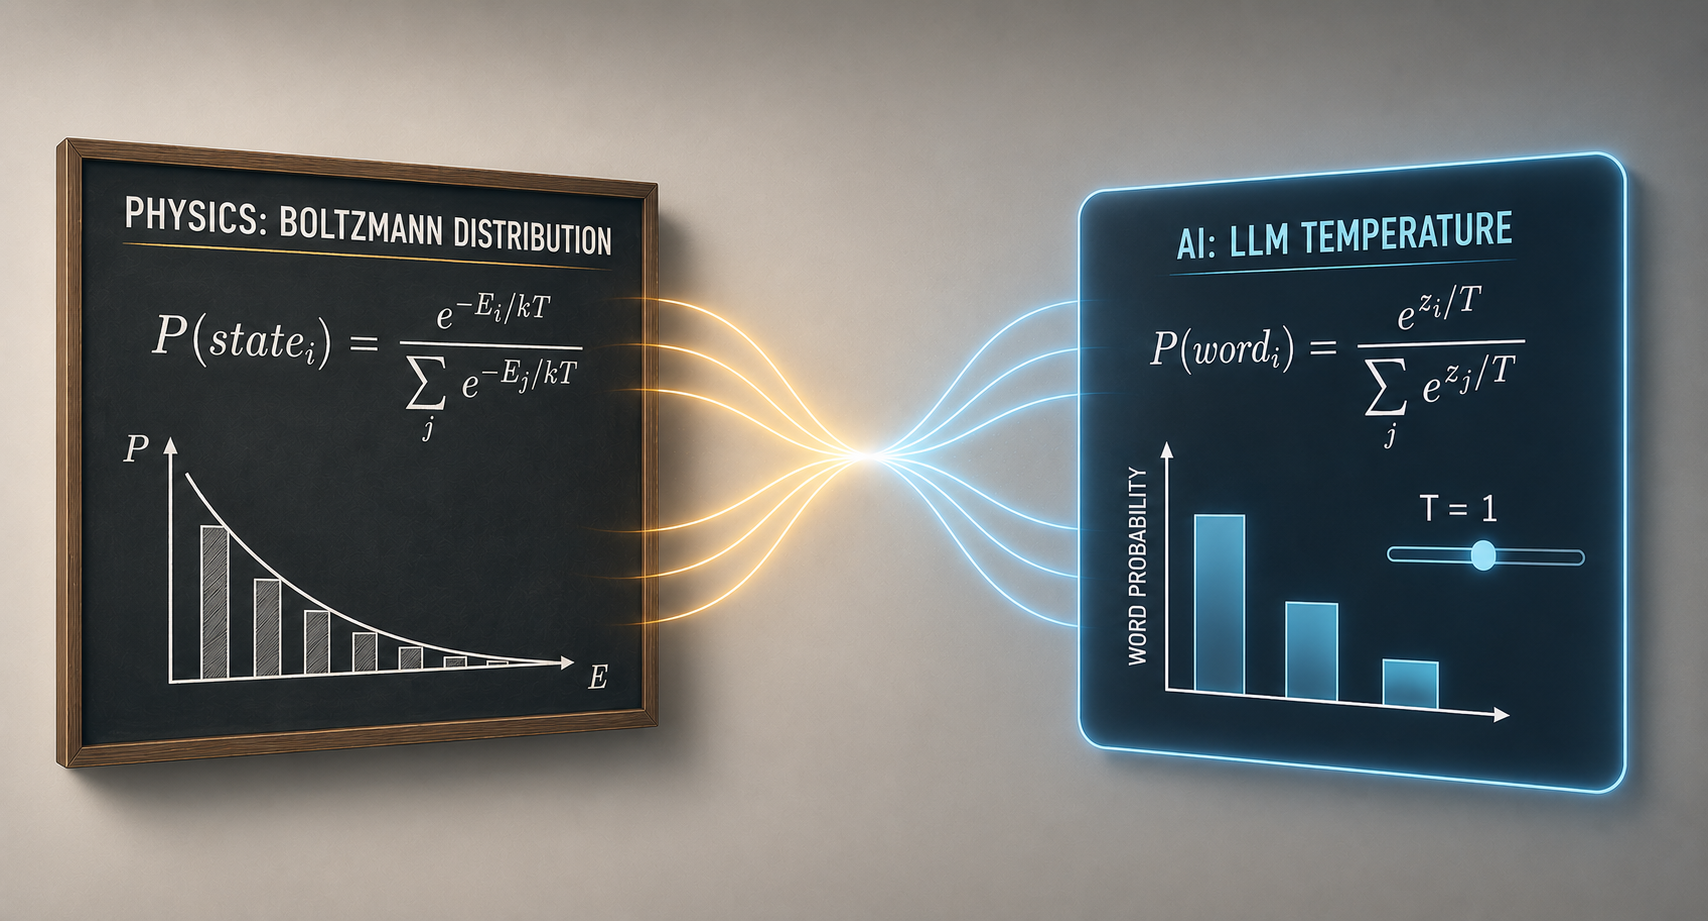
C’est toute la distribution Boltzmann.
Malgré son apparence intimidante, l’équation n’effectue que deux opérations. L’exponentielle traduit l’énergie en préférence relative. Le dénominateur redimensionne ces préférences afin qu’elles forment une distribution de probabilité valide. Ce qui ressemble au premier abord à une formule compliquée n’est en réalité qu’une étape de pondération suivie d’une étape de normalisation.
Une fois que cette image est claire pour le lecteur, activons la variable de température. Notez que la température ne modifie jamais les énergies elles-mêmes. Au lieu de cela, cela change l’importance de ces différences d’énergie.
Considérons trois états possibles avec les énergies 0, 1 et 2. À très basse température, disons même ces modestes différences d’énergie deviennent énormes à l’intérieur de l’exponentielle. L’état d’énergie la plus basse capture presque toute la probabilité, tandis que les deux autres deviennent pratiquement impossibles. Augmentez la température à et c’est le contraire qui se produit. Les mêmes différences d’énergie sont désormais fortement comprimées, produisant des poids presque identiques et une distribution presque uniforme.
Jetez un œil aux deux tableaux suivants pour mieux visualiser le concept (en supposant pour plus de simplicité que k=1) :
| Énergie | poids si T=0,1 | Probabilité (%) |
| 0 | 1 | 99,99 |
| 1 | 0,000045 | 0,0045 |
| 2 | 0,000000002 | ~0 |
| Énergie | poids si T=10 | Probabilité |
| 0 | 1 | 36,7 |
| 1 | 0,905 | 33.2 |
| 2 | 0,819 | 30.1 |
Rien n’a changé dans les États. Leurs énergies sont restées 0, 1 et 2 tout au long. Seul le importance de ces différences ont changé.
C’est le rôle de la température dans la distribution de Boltzmann. Cela ne change pas les énergies et n’introduit pas de nouveaux termes dans l’équation. Il contrôle simplement l’agressivité avec laquelle la distribution de probabilité favorise les états à faible énergie. Les basses températures amplifient les petites différences d’énergie avec une quasi-certitude. Les températures élevées aplatissent ces différences jusqu’à ce que chaque état devienne presque également plausible.
Cette idée peut sembler uniquement physique, mais ce n’est pas le cas. Dans la section suivante, le même mécanisme mathématique réapparaîtra discrètement au sein de chaque réseau neuronal produisant des probabilités.
L’équivalence LLM : le vocabulaire en tant qu’États
Pour voir comment cela se connecte aux grands modèles linguistiques, il nous suffit de modifier les étiquettes de nos variables.
En physique, notre système pourrait être un gaz, et les « états » sont les différents niveaux d’énergie que ses molécules peuvent occuper. Dans un LLM, le système est le moment exact dont le modèle a besoin pour prédire le mot suivant. Les « états » constituent l’ensemble du vocabulaire du modèle, c’est-à-dire des dizaines de milliers de mots (ou jetons) possibles en compétition pour être choisis ensuite.
Lorsqu’un LLM traite votre invite, il n’affiche pas immédiatement les probabilités. Sa dernière couche neuronale crache des nombres bruts et non normalisés pour chaque mot de son vocabulaire. En Machine Learning, nous appelons ces scores bruts logits (). Un mot peut avoir un logit de 12,5, un autre de -3,2 et un autre de 0,8.
Voici le pont conceptuel crucial : Les logits sont l’énergie du modèle, mais inversée.
La nature est par nature paresseuse et a tendance à favoriser les états à faible énergie. Les réseaux de neurones, en revanche, sont gourmands ; ils préfèrent généralement les prédictions avec le le plus élevé score possible ().
Softmax est Boltzmann déguisé
Pour transformer ces logits bruts et illimités en une distribution de probabilité propre dont la somme est égale à un, les ingénieurs ML utilisent la fonction Softmax. Si nous incluons explicitement le paramètre de température (T), l’équation Softmax ressemble à ceci :
Vous semblez familier ? C’est exactement la même astuce mathématique. Nous remplaçons l’énergie négative avec nos logits positifs . Nous exponentions pour transformer les scores en poids relatifs, et nous divisons par la somme de tous les poids pour les normaliser. Softmax n’est que la distribution Boltzmann portant un trench-coat informatique.
Comment la température contrôle la « chaleur » du texte
Parce que les calculs sont identiques, le paramètre de température se comporte mathématiquement exactement comme en thermodynamique. Cela ne modifie pas les croyances sous-jacentes du modèle puisque les logits bruts restent inchangés. Au lieu de cela, cela dicte la rigueur avec laquelle le modèle applique ces croyances.
Voyons comment le réglage du thermostat modifie le comportement d’un LLM :
- Zéro absolu (T=0) : L’État déterministe avide:
À mesure que la température approche de zéro, même les différences microscopiques des logits sont amplifiées à l’infini. Si « pomme » a un logit de 5,01 et « banane » en a 5,00, la division par une infime température rend cette différence de 0,01 disproportionnée. « Apple » captera 99,99% de la masse de probabilité. Le modèle devient une machine déterministe, choisissant toujours le mot le plus performant. Ceci est idéal pour les tâches nécessitant une logique stricte, comme écrire du code Python, résoudre des équations mathématiques ou extraire des données JSON. Il n’y a pas de place pour le hasard. - Température ambiante (T = 1) : la référence:
À T=1, la température disparaît effectivement de l’équation. Le modèle génère la distribution de probabilité exacte qu’il a apprise au cours de sa formation. Le texte coule naturellement, équilibrant la grammaire attendue avec la variance naturelle du langage humain. - Chaleur élevée (T > 1) : le chaos créatif:
Lorsque nous augmentons la température, nous comprenons les différences entre les logits. La fonction exponentielle s’aplatit. Le mot ayant le score le plus élevé perd sa domination absolue et les mots ayant le score le plus faible commencent à capturer une masse de probabilité significative.
Pensez à la physique statistique : à haute température, les molécules de gaz ont tellement d’énergie thermique qu’elles peuvent facilement accéder à des états énergétiques plus élevés et plus difficiles. Dans un LLM, la température élevée donne à l’algorithme « l’énergie » nécessaire pour accéder à des mots mathématiquement improbables. Le modèle prend des risques. Cela devient créatif, poétique et imprévisible.
Si vous poussez la température trop haut (par exemple, ), la répartition devient presque totalement uniforme. Le modèle perd son emprise sur le contexte et commence à générer du texte incohérent, presque aléatoire, plus proche du bruit que du langage.
Un détail petit mais important : T = 0 n’est pas vraiment zéro
Il y a une ride subtile qui mérite d’être connue si vous avez déjà posé dans un appel API. Mathématiquement, ne devrait pas être défini, vous diviseriez chaque logit par zéro, ce que la formule ne peut tout simplement pas gérer. Alors, que se passe-t-il réellement lorsque vous le demandez ?
En pratique, les bibliothèques d’inférence LLM ne calculent pas littéralement . Plutôt, est traité comme une instruction spéciale : ignorez complètement la formule softmax et choisissez directement le logit ayant obtenu le score le plus élevé. Ceci s’appelle décodage gourmandtoujours en sortie le jeton avec le score brut le plus élevé, pas d’exponentielles, pas de normalisation, pas de distribution de probabilité du tout.
Le résultat ressemble à une distribution de Boltzmann extrêmement froide, presque toutes les probabilités étant empilées sur un seul état. Mais il y a une différence dans comment tu y arrive. Mathématiquement, vous atteindriez ce résultat progressivement, en refroidissant T vers zéro et en observant la distribution s’affiner étape par étape. Dans le code, il n’y a pas de refroidissement progressif du tout, juste un raccourci qui passe directement à la réponse.
Regarder cela se produire : vrais logits de GPT-2
Jusqu’à présent, tout a été prouvé avec des numéros de jouets, trois états abstraits, une poignée de logits inventés pour « pomme » et « banane ». Remplaçons cela par quelque chose de réel. GPT-2, un petit modèle de langage disponible gratuitement, nous fournira de véritables logits pour une phrase réelle, et nous pourrons regarder softmax les remodeler devant nous, à quatre températures différentes.
La configuration est simple : indiquez au modèle « Je suis fatigué, je vais prendre un __ » et demandez-lui ce qui va suivre. En interne, il produit un logit brut pour chaque mot de son vocabulaire, soit des dizaines de milliers de nombres. Pour la visualisation, nous conserverons uniquement les cinq premiers logits candidats et les renormaliserons avec softmax uniquement sur ces cinq à T = 0,1, 0,5, 1,0 et 2,0.
import torch
import numpy as np
import matplotlib.pyplot as plt
from transformers import GPT2LMHeadModel, GPT2Tokenizer

# Load GPT-2
tokenizer = GPT2Tokenizer.from_pretrained("gpt2")
model = GPT2LMHeadModel.from_pretrained("gpt2")
model.eval()

# Get real logits for the next token
prompt = "I am tired, I will take a"
input_ids = tokenizer.encode(prompt, return_tensors="pt")

with torch.no_grad():
    outputs = model(input_ids)
    logits = outputs.logits[0, -1, :]

# Top 5 candidate tokens by raw logit
top5 = torch.topk(logits, 5)
top_ids = top5.indices
top_logits = top5.values
tokens = [tokenizer.decode([tid]) for tid in top_ids]

print(f'Prompt: "{prompt}"\n')
print("Top 5 candidate next tokens (raw logits):")
for t, l in zip(tokens, top_logits):
    print(f"  {t!r:10s}  logit = {l.item():.2f}")

# Run Softmax for different temperatures
temps = [0.1, 0.5, 1.0, 2.0]
results = {}
for T in temps:
    probs = torch.softmax(top_logits / T, dim=0).numpy()
    results[T] = probs
    print(f"\nT = {T}")
    for t, p in zip(tokens, probs):
        print(f"  {t!r:10s}  P = {p*100:.2f}%")

# Plots
fig, axes = plt.subplots(2, 2, figsize=(10, 8), sharey=True)
axes = axes.flatten()
colors = plt.cm.coolwarm(np.linspace(0.15, 0.85, len(tokens)))

for ax, T in zip(axes, temps):
    probs = results[T]
    ax.bar(tokens, probs * 100, color=colors)
    ax.set_title(f"T = {T}", fontsize=12)
    ax.set_ylim(0, 105)
    ax.tick_params(axis='x', rotation=45)
    ax.set_ylabel("Probability (%)")

fig.suptitle(f'Next-token distribution for: "{prompt} ___"', fontsize=14)
plt.tight_layout()
plt.savefig("temperature_sweep.png", dpi=150, bbox_inches="tight")
plt.show()
Lisez les quatre panneaux dans l’ordre et vous observerez la température faire exactement ce qu’elle a fait plus tôt à notre système de jouets à trois états, tout à l’heure sur des mots qu’un modèle réel a réellement prédit. À « Nap » prend pratiquement tout, 100 %, les quatre autres candidats n’inscrivent même pas de barre visible. À la « sieste » domine toujours autour de 74 %, mais la « pause » prend une part réelle et visible proche de 18 % ; le reste reste mineur. À les préférences relatives du modèle parmi ces cinq candidats apparaissent sans aucune échelle de température : « sieste » arrive en tête à environ 49 %, tandis que « pause », « repos », « bain » et « douche » conservent tous des probabilités significatives et visiblement distinctes. Pousser vers et les écarts se resserrent encore davantage, « nap » borde le peloton à environ 34 %, les quatre autres étant regroupés de près au lieu d’être à la traîne.
Rien dans le modèle n’a changé sur ces quatre panneaux. Ni les poids, ni l’entraînement, ni même les logits eux-mêmes, ceux-là sont restés figés tout le temps. La seule chose qui a changé, c’est la manière agressive avec laquelle ces logits fixes ont été convertis en une distribution de probabilité. C’est toute la leçon de cet article, contenue dans une seule phrase : la température n’est pas une question de créativité ou de hasard en tant qu’ingrédient distinct. C’est la même chose que la physique du cadran a transformée depuis plus d’un siècle, désormais induite dans la dernière couche d’un réseau neuronal.
Boucler la boucle
Reprenez là où se trouvait cet article : un récipient de gaz scellé et une question sur la probabilité qu’une seule molécule se trouve dans un état énergétique par rapport à un autre. Rien dans cette question ne mentionnait le langage, les jetons ou les réseaux de neurones. Et pourtant, au moment où GPT-2 finit de prédire le mot après « Je suis fatigué, je vais prendre un », il exécute le même calcul, pondérant les scores bruts en probabilités, puis laissant un seul paramètre décider de l’ampleur avec laquelle ces probabilités devraient s’engager pour un gagnant.
Ce paramètre a conservé le même nom pour une raison. Ce n’est pas une métaphore empruntée pour rendre une équation plus intéressante. La température dans un LLM fait, mathématiquement, exactement ce que la température fait dans un gaz : elle décide dans quelle mesure les différences entre les options peuvent avoir de l’importance. Froid, et une option avale tout. Chaud, et chaque option se brouille vers le même haussement d’épaules d’une probabilité.
Ainsi, la prochaine fois que vous pousserez un curseur de température, devant un assistant de codage, un chatbot, un générateur d’histoires, vous n’ajusterez pas un « bouton de créativité » ad hoc inventé pour l’occasion. Vous tournez un cadran que les physiciens tournaient déjà un siècle avant l’existence du premier réseau neuronal, en pointant simplement, cette fois, une phrase au lieu d’un gaz.

You may also like


Comment inviter efficacement le code Claude