
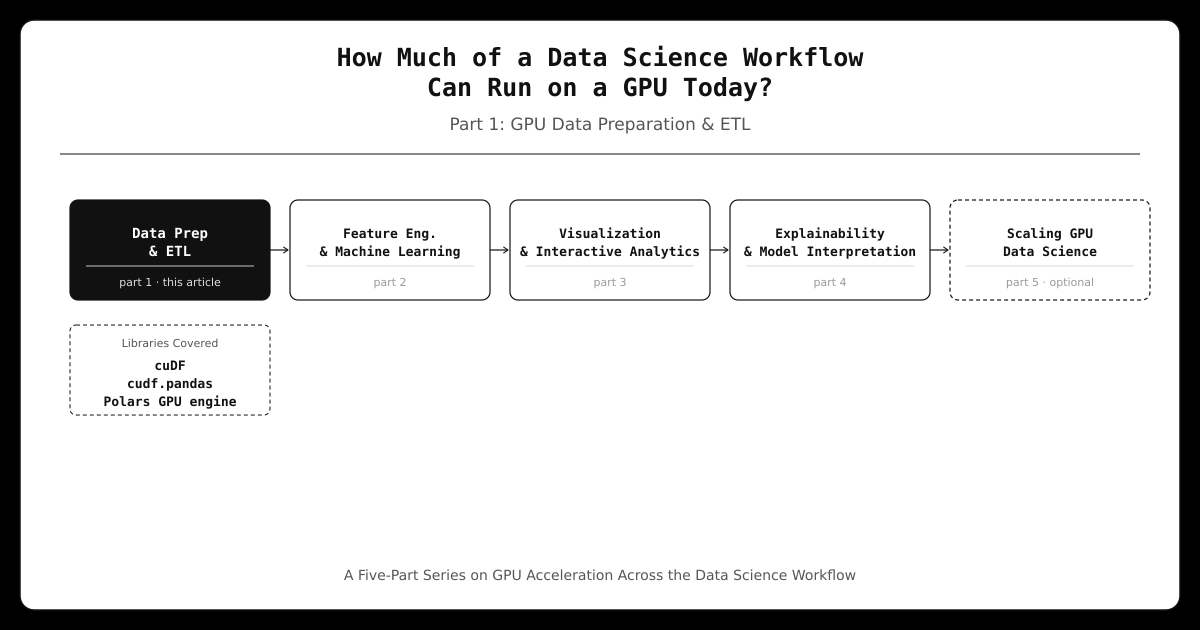
Dans quelle mesure un workflow de science des données peut-il s’exécuter sur un GPU aujourd’hui ? Partie 1 : Accélération de la préparation des données
passent une grande partie de leur temps à travailler avec des données tabulaires. Traditionnellement, ces charges de travail s’exécutent sur des processeurs, ce qui est souvent suffisant jusqu’à ce qu’une opération coûteuse devienne un goulot d’étranglement. Pendant ce temps, une grande partie des discussions autour des GPU se concentre sur l’apprentissage profond et les grands modèles de langage. Aujourd’hui, cependant, l’accélération GPU est disponible dans une grande partie de la pile de science des données Python, permettant à de nombreux flux de travail de données tabulaires existants de s’exécuter sur des GPU avec peu ou pas de modifications de code.
De nombreuses discussions autour des GPU se concentrent sur l’apprentissage profond et les grands modèles de langage. Cependant, de nombreux data scientists passent encore la plupart de leur temps à travailler avec des données tabulaires, où la plupart de ces charges de travail s’exécutent traditionnellement sur des processeurs. Cela convient généralement jusqu’à ce qu’une opération coûteuse devienne un goulot d’étranglement. L’illustration ci-dessous illustre cela de manière légère.

Aujourd’hui, la prise en charge des GPU est disponible dans une grande partie de la pile de science des données Python, ce qui permet aux data scientists d’accélérer de nombreux flux de travail existants avec peu ou pas de modification du code. Cela réduit le temps passé à attendre la fin des opérations coûteuses, ce qui laisse plus de temps pour se concentrer sur la résolution du problème réel.
J’ai décidé de parcourir un pipeline d’apprentissage automatique typique, étape par étape, pour voir où l’accélération GPU est disponible aujourd’hui et à quel point elle est pratique à utiliser. Dans cette série, je vais parcourir un pipeline d’apprentissage automatique typique, étape par étape, pour voir où l’accélération GPU est disponible aujourd’hui, quelle quantité de code doit changer et quand les processeurs restent le meilleur choix.
Nous commencerons par le traitement des données tabulaires et les tâches de préparation des données qui font partie de nombreux flux de travail quotidiens de science des données.
Ensemble de données et code
Tout au long de cet article, nous utiliserons le Dossiers de voyage en taxi jaune à New York base de données (licence CCO), elle contient des millions de trajets en taxi collectés dans la ville de New York, avec des informations telles que les lieux de prise en charge et de dépose, la distance du trajet, le nombre de passagers, les tarifs et les horodatages. Pour cet article, nous n’utiliserons que les trois premiers mois, ce qui nous donne environ 9 à 10 millions de lignes.
Pour que les exemples restent concentrés, j’ai omis certains codes passe-partout et raccourci quelques extraits. Le code complet est disponible ici.
Accélération des flux de travail Pandas sur GPU
Si votre pipeline de traitement de données est construit avec des pandas, il existe deux manières simples de l’exécuter sur le GPU :

cudf.pandas.- Travailler directement avec le natif cuDF API.
- Accélérer le code pandas existant avec
cudf.pandas.
Examinons ces deux approches.
1. Création de workflows GPU natifs avec l’API cuDF
Si vous démarrez un nouveau projet et souhaitez travailler directement avec des DataFrames GPU, cuDF pourrait être une excellente option. Cela fait partie de RAPIDES la suite open source de bibliothèques accélérées par GPU de NVIDIA pour la science et l’analyse des données.
cuDF est une bibliothèque Python GPU DataFrame permettant de manipuler des données tabulaires à l’aide d’une API de type pandas. Donc, si vous êtes familier avec les pandas, une grande partie de la syntaxe vous semblera familière. La différence, cependant, est que contrairement aux pandas, cuDF exécute ces opérations sur le GPU plutôt que sur le CPU. Il convient cependant de noter que même si cuDF suit de près l’API pandas, il ne s’agit pas d’un remplacement complet, donc certains comportements peuvent différer.
Installation
Si vous utilisez Google Colab, cuDF est déjà disponible dans le runtime GPU. Sinon, installez le package cuDF qui correspond à votre version CUDA installée.
Vous pouvez vérifier votre version CUDA en exécutant :
!nvidia-smi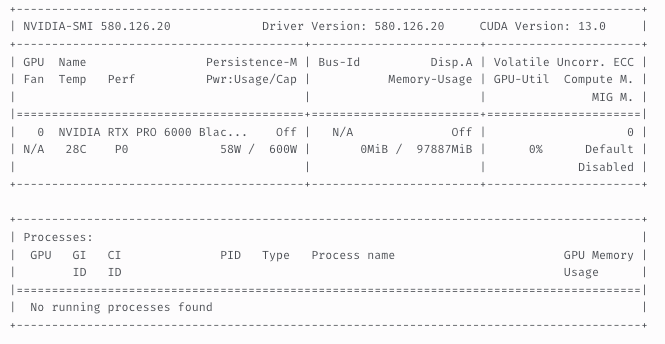
Par exemple, si votre système signale CUDA 13.xinstallez la version CUDA 13 de cuDF :
pip install cudf-cu13Référez-vous au guide d’installation pour la liste complète des options d’installation et des versions CUDA prises en charge.
Chargement de données dans un cuDF DataFrame
Le chargement de données dans un cuDF DataFrame fonctionne comme les pandas. Dans la plupart des cas, vous remplacez simplement pandas.read_* avec le correspondant cudf.read_* fonction. Voici comment charger un fichier Parquet à l’aide de cuDF :
import cudf

taxi_url = 'https://d37ci6vzurychx.cloudfront.net/trip-data/yellow_tripdata_2023-01.parquet'

df_gpu = cudf.read_parquet(taxi_url)
df_gpu.info()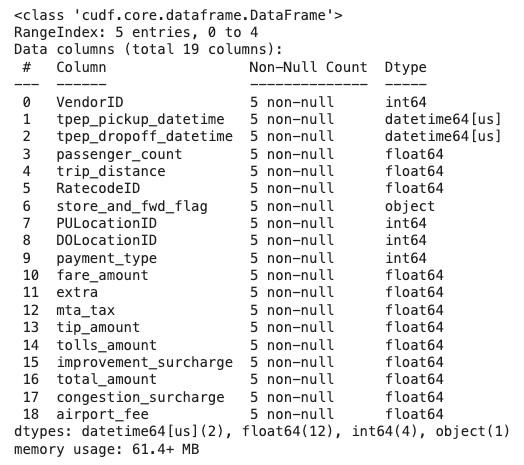
Une fois les données chargées dans la mémoire du GPU, les opérations DataFrame suivantes s’exécutent sur le GPU.
Travailler avec cuDF
cuDF prend en charge bon nombre des opérations que vous utilisez déjà dans les pandas. Voici quelques exemples courants :
Sélection de colonnes
trips = df_gpu[ [ "PULocationID", "DOLocationID", "fare_amount", "trip_distance", "tip_amount", ] ]Filtrage des lignes
high_fare = trips[trips["fare_amount"] > 20]Création de nouvelles colonnes
trips["tip_percentage"] = ( trips["tip_amount"] / trips["fare_amount"] * 100 )Statistiques récapitulatives
trips.describe()Passer entre les pandas et cuDF
De nombreux workflows de science des données utilisent des bibliothèques qui ne prennent en charge que les pandas. Vous pouvez facilement déplacer des données entre les DataFrames CPU et GPU à l’aide de cuDF, si nécessaire.
Conversion d’un DataFrame pandas en cuDF :
df_gpu = cudf.from_pandas(df_cpu)
print(type(df_gpu_converted))
---------------------------------------
<class 'cudf.core.dataframe.DataFrame'>
Reconversion d’un DataFrame cuDF en pandas :
df_cpu = df_gpu.to_pandas(
print(type(df_cpu_converted))
---------------------------------------
<class 'pandas.core.frame.DataFrame'>
Ces conversions sont utiles lorsqu’une bibliothèque en aval ne prend en charge que les pandas ou lorsque vous souhaitez migrer un workflow existant vers le GPU.
Comparaison des pandas et du cuDF
Pour voir la différence de performances dans la pratique, exécutons la même analyse en utilisant à la fois pandas et cuDF. Nous regrouperons les trajets par lieu de prise en charge et calculerons le montant total du tarif, la distance moyenne du trajet et le nombre de trajets pour chaque emplacement.
def summarize_trips(df):
    return (
        df.groupby("PULocationID")
          .agg(
              {
                  "fare_amount": "sum",
                  "trip_distance": "mean",
                  "passenger_count": "count",
              }
          )
          .sort_values("fare_amount", ascending=False)
    )
%time summary_pd = summarize_trips(df_cpu)
%time summary_gpu = summarize_trips(df_gpu)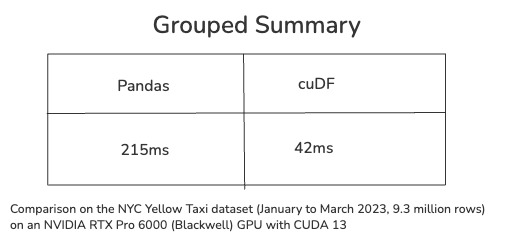
Le traitement des données du monde réel consiste rarement en une seule opération. Cela implique souvent plusieurs opérations DataFrame enchaînées. À titre de comparaison supplémentaire, exécutons un flux de travail plus réaliste en recherchant le lieu de dépôt le plus courant pour chaque lieu de prise en charge.
def run_chain(df):
    return (
        df[["PULocationID", "DOLocationID"]]
        .value_counts()
        .reset_index(name="count")
        .sort_values(
            ["PULocationID", "count"],
            ascending=[True, False],
        )
        .groupby("PULocationID")
        .head(1)
        .reset_index(drop=True)
    )
%time result_pd = run_chain(df_cpu)
%time result_gpu = run_chain(df_gpu)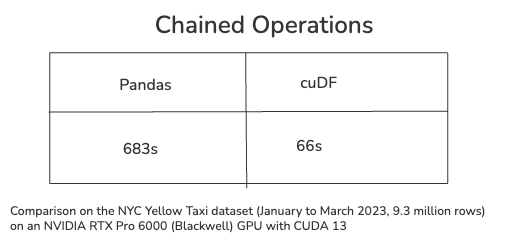
Comparaison des agrégations lourdes
Les agrégations Groupby font partie des opérations les plus courantes dans les pipelines d’analyse et sont bien adaptées à l’accélération GPU car elles sont coûteuses. Évaluons une agrégation groupée sur plusieurs colonnes.
def aggregate(df):
    return (
        df.groupby("PULocationID")
          .agg(
              {
                  "fare_amount": "sum",
                  "trip_distance": "sum",
                  "passenger_count": "count",
              }
          )
    )
%time agg_pd = aggregate(df_cpu)
%time agg_gpu = aggregate(df_gpu)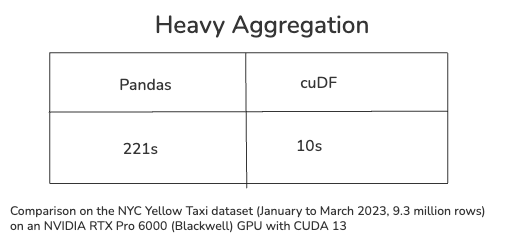
Même sur cet ensemble de données, nous pouvons constater une accélération significative, et sur des ensembles de données plus volumineux, ces charges de travail d’agrégation peuvent bénéficier considérablement du parallélisme GPU.
2. Accélérer le code pandas existant avec cudf.pandas
Puis-je accélérer mon code pandas existant sans le réécrire ?
Bien que l’API cuDF native soit un excellent choix pour les nouveaux projets axés sur le GPU, de nombreux flux de travail de science des données existants sont déjà construits autour des pandas et la réécriture de tout le code demande un peu de travail. C’est ici cudf.pandas Il s’agit d’un mode accélérateur intégré à cuDF qui permet d’accélérer votre code pandas sans aucune modification du code.
Activer l’accélérateur
Pour activer l’accélération GPU dans un ordinateur portable, chargez l’extension avant importer pandas:
%load_ext cudf.pandas
import pandas as pd
Pour les scripts Python, vous pouvez écrire :
python −m cudf.pandas script.pyC’est le même code pandas
Nous utiliserons les mêmes données et le même code de la section précédente. Le seul changement est d’inclure le %load_ext cudf.pandas ligne en haut, qui active l’accélérateur.
%load_ext cudf.pandas
import pandas as pd

taxi_url = 'https://d37ci6vzurychx.cloudfront.net/trip-data/yellow_tripdata_2023-01.parquet'

df = pd.read_parquet(taxi_url)

summary = (
    df.groupby("PULocationID")
      .agg(
          {
              "fare_amount": "sum",
              "trip_distance": "mean",
              "passenger_count": "count",
          }
      )
      .sort_values("fare_amount", ascending=False)
)

summary
Vous pouvez vérifier que cudf.pandas est actif en imprimant le module pandas :
print(pd)
-------------------------------------------
<module 'pandas' (ModuleAccelerator(fast=cudf, slow=pandas))>
Chaque opération pandas est d’abord tentée sur le GPU à l’aide de cuDF. Si une opération n’est pas prise en charge, cudf.pandas revient automatiquement aux pandas sur le processeur.

cudf.pandas. Illustration de l’auteur, d’après le RAPIDS cudf.pandas documentation.Profilage de l’exécution du GPU et du CPU
Plutôt que de deviner quelles opérations ont été exécutées sur le GPU, cudf.pandas inclut un profileur intégré qui signale l’exécution du GPU et les replis du CPU.
%%cudf.pandas.profile
summary = (
    df.groupby("payment_type")
      .fare_amount.mean()
)
Une fois la cellule terminée, le profileur génère un rapport indiquant quelles opérations ont été exécutées sur le GPU et lesquelles sont revenues au CPU.

Pour une analyse plus détaillée, %%cudf.pandas.line_profile indique le temps que chaque ligne de code passe à s’exécuter sur le GPU et le CPU.
%%cudf.pandas.line_profile
summary = (
    df.groupby("payment_type")
      .fare_amount.mean()
)
Travailler avec des bibliothèques tierces
Parce que cudf.pandas préserve l’API pandas, de nombreuses bibliothèques qui fonctionnent avec les pandas continuent également de fonctionner sans modification. Cela signifie qu’une fois les données traitées, elles peuvent être transmises directement à des bibliothèques telles que Plotly Express sans modifier le code en aval.
import plotly.express as px

top10 = summary.head(10).reset_index()

fig = px.bar(
    top10,
    x="PULocationID",
    y="fare_amount",
    title="Top 10 Pickup Locations by Total Fare",
    labels={
        "PULocationID": "Pickup Location ID",
        "fare_amount": "Total Fare",
    },
)

fig.show()
Cela produit la même visualisation interactive que nous créerions avec un DataFrame pandas classique, mais maintenant c’est beaucoup plus rapide. De plus, puisque le code en aval reste inchangé, il est très simple d’incorporer l’accélération GPU dans les notebooks et pipelines existants sans modifier votre flux de travail de visualisation.
2. Utilisation du moteur GPU Polars
Polaires est déjà connu pour son moteur DataFrame rapide et son API Lazy. Mais si vous travaillez avec de grands ensembles de données, vous pouvez également profiter de l’accélération GPU via le moteur GPU polaires alimenté par cuDF.
Comme cudf.pandasil permet d’accélérer les flux de travail existants avec un minimum de changements. Lorsque vous exécutez une requête paresseuse, Polars crée d’abord un plan de requête optimisé. Si les opérations du plan sont prises en charge sur le GPU, elles sont exécutées à l’aide de cuDF, sinon Polars passe automatiquement à son moteur CPU standard. La figure ci-dessous illustre ce flux d’exécution.

Installation
Le moyen le plus simple d’installer le moteur GPU consiste à utiliser le package GPU Polars en option, qui installe automatiquement les dépendances RAPIDS requises.
pip install "polars[gpu]"

or

# Direct cuDF-backed Polars engine install option for CUDA 12

pip install -q polars cudf-polars-cu12 --extra-index-url=https://pypi.nvidia.
Activation de l’accélération GPU pour Polars
Nous utiliserons le même ensemble de données sur les taxis de New York et effectuerons la même analyse que dans les sections précédentes. La seule différence est qu’on l’exécute avec le moteur GPU en passant engine="gpu" à collect().
import polars as pl
taxi_url = "https://d37ci6vzurychx.cloudfront.net/trip-data/yellow_tripdata_2023-01.parquet"
query = (
    pl.scan_parquet(taxi_url)
      .group_by("PULocationID")
      .agg(
          fare_amount=pl.col("fare_amount").sum(),
          trip_distance=pl.col("trip_distance").mean(),
          trip_count=pl.len(),
      )
      .sort("fare_amount", descending=True)
)
summary = query.collect(engine="gpu")
summary.head()
La requête elle-même est la même que celle d’un Polars standard Cadre paresseux flux de travail. La seule différence est que maintenant nous passons engine="gpu" dans collect()qui indique à Polars d’exécuter la requête à l’aide du moteur GPU, s’il est pris en charge. Cependant, si la requête contient des opérations non prises en charge, Polars revient automatiquement à son moteur CPU.
Vérification de l’exécution du GPU
Pour vérifier si une requête s’est exécutée sur le GPU, vous pouvez activer le mode détaillé avant d’appeler collect(). Si une requête ne peut pas être exécutée sur le GPU, Polars imprime un PerformanceWarning expliquant pourquoi cela est revenu au processeur. Vous pouvez également désactiver le repli automatique en passant pl.GPUEngine(raise_on_fail=True) à collect()ce qui génère une erreur si la requête n’est pas prise en charge sur le GPU.
unsupported_gpu_operation = (
    df_lazy
    .select(
        pl.col("fare_amount")
        .map_elements(lambda fare: fare * 1.1, return_dtype=pl.Float64)
        .alias("fare_with_markup")
    )
    .head(10)
)

with pl.Config() as cfg:
    cfg.set_verbose(True)
    fallback_result = unsupported_gpu_operation.collect(engine="gpu")

print(fallback_result)
Dans l’exemple ci-dessus, nous utilisons intentionnellement map_elements() avec une fonction Python. Les fonctions Python ne sont pas prises en charge par le moteur GPU Polars, cette requête ne peut donc pas s’exécuter entièrement sur le GPU.
Mise à l’échelle vers plusieurs GPU
L’exemple ci-dessus utilise un seul GPU. Si vous travaillez avec des ensembles de données plus volumineux ou si vous avez accès à plusieurs GPU, vous pouvez passer à RayEngine avec seulement un petit changement.
from cudf_polars.engine.ray import RayEngine
with RayEngine() as engine:
    summary = query.collect(engine=engine)
RayEngine utilise automatiquement tous les GPU visibles par le processus, permettant à la même requête paresseuse de passer d’un GPU à plusieurs GPU. Si vous souhaitez en savoir plus sur la façon dont le moteur GPU Polars évolue sur plusieurs GPU, Benjamin Zaitlen a un bel article de blog qui passe en revue les concepts et comprend des exemples de performances.
Conclusion
Ce que j’ai découvert à partir des tests de référence et de mes propres expériences, c’est que les GPU sont plus utiles pour les opérations volumineuses et gourmandes en données telles que le filtrage, les jointures, les agrégations groupées et le tri. Cependant, pour les ensembles de données plus petits, les processeurs sont souvent tout aussi rapides en raison de la surcharge liée au déplacement des données vers le GPU impliqué. Grâce à des bibliothèques comme cudf, nous n’avons plus besoin de réécrire une base de code entière pour accélérer le traitement et l’analyse des données. Nous pouvons basculer entre l’exécution GPU et CPU en fonction de la charge de travail. Cela signifie que nous passons moins de temps à attendre la fin des requêtes et plus de temps à nous concentrer sur d’autres parties importantes du flux de travail de la science des données.
Dans le prochain article, nous irons au-delà de la préparation des données et explorerons l’accélération GPU pour les bibliothèques d’apprentissage automatique et verrons quelle quantité de code doit réellement changer pour accélérer la formation des modèles.
Remarque : toutes les images de cet ouvrage sont de l’auteur, sauf indication contraire ou attribution.

You may also like

Comment décoder le paramètre de température dans les LLM

