
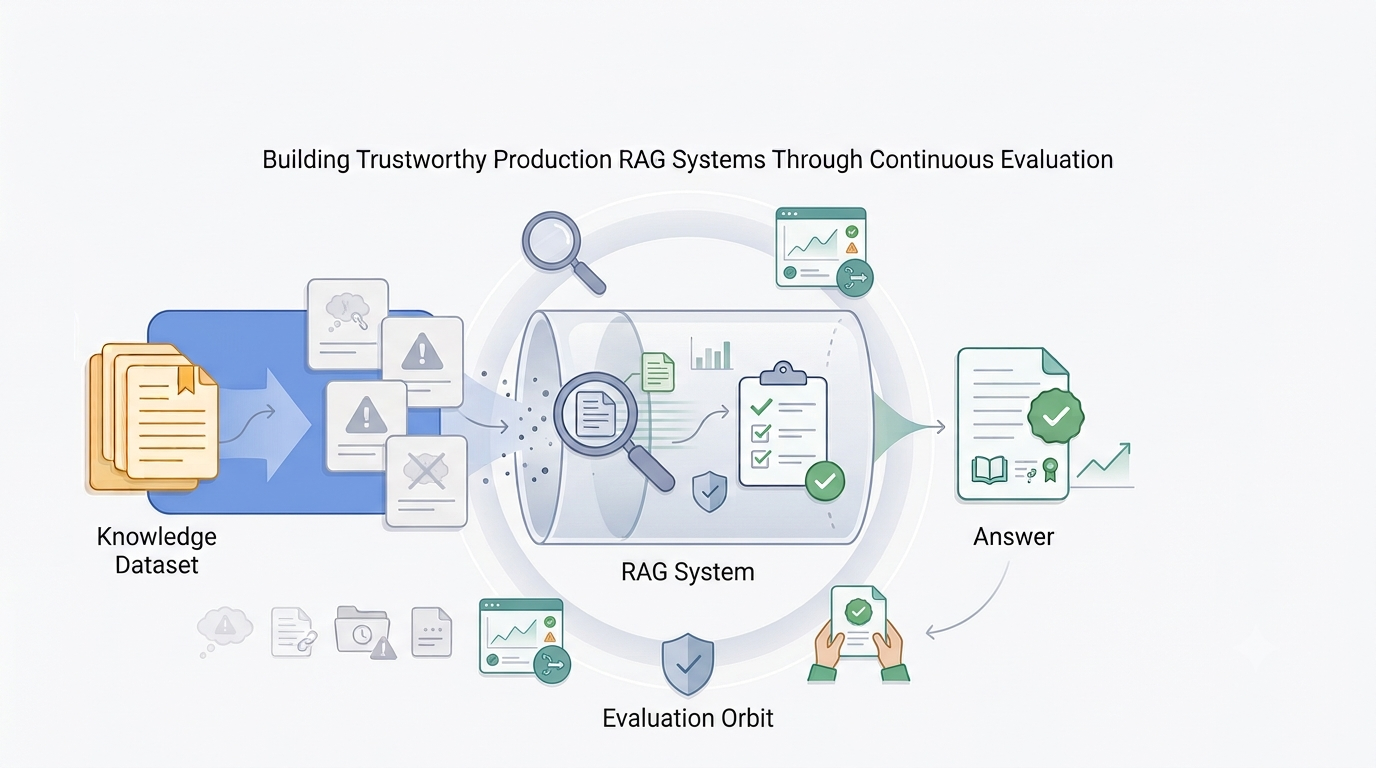
Construire des systèmes RAG de production fiables grâce à une évaluation continue
alors vous avez déjà vécu cette situation où il semble que votre système RAG fonctionne correctement mais qu’il est toujours faux. La récupération récupère quelques morceaux, les transmet au modèle génératif et écrit une réponse fluide. Rien ne génère d’erreur, et pourtant la réponse peut être construite sur le mauvais document, ou manquer la moitié des informations dont elle avait besoin, ou encore s’appuyer sur quelque chose qui est techniquement vrai mais dont trois versions sont obsolètes. La seule façon de réellement le savoir et d’atténuer ce problème est de l’évaluer correctement et régulièrement.
Cet article explique comment créer vous-même ce pipeline d’évaluation, en commençant par les parties qui semblent trop basiques pour être écrites, en passant par l’évaluation automatisée avec RAGAS, au-delà du point où RAGAS cesse d’être suffisant, et ce qu’il faut pour exécuter cela comme un processus réel plutôt qu’un cahier que vous ouvrez avant une réunion des parties prenantes. Les étapes sont écrites afin que vous puissiez les suivre pour votre propre application RAG, et pas seulement les lire comme de la théorie.
C’est la quatrième partie de La série RAG pour Entrepriseet si vous avez manqué les parties précédentes, je vous recommande fortement de consulter la partie 3 ici : Recherche hybride et reclassement dans Production RAG
Qu’y a-t-il dans cet article
- Construire l’ensemble de données d’or
- Effectuer une simple vérification manuelle avant d’automatiser
- Automatisez la notation avec RAGAS
- Ajout d’un juge LLM personnalisé pour ce que RAGAS ne peut pas vérifier
- Utiliser un humain dans la boucle
- Surveillez la dérive après l’expédition du système
- L’exécuter en tant que pipeline
- Conclusion
Construire l’ensemble de données d’or
Avant de toucher à une bibliothèque d’évaluation, vous avez besoin d’un ensemble de questions avec des réponses correctes connues. C’est ce qu’on appelle un ensemble de données doréet l’ignorer est l’erreur la plus courante que commettent les équipes lorsqu’elles travaillent sur un système RAG. Passer directement à l’exécution de RAGAS sur des requêtes aléatoires sans rien à comparer ne vous dit presque rien si le système est réellement bon ou faux.
Une bonne entrée de jeu de données dorée comporte trois parties : la question, une réponse correcte écrite par quelqu’un qui connaît le domaine et quel document contient la réponse. Le troisième champ est ce qui vous permet de distinguer un échec de récupération (mauvais morceau récupéré) d’un échec de génération (bon morceau, mauvaise réponse écrite à partir de celui-ci). Ce sont des bogues différents avec des correctifs différents, et un ensemble de données sans ce champ vous laissera déboguer en aveugle.
golden_set = [
    {
        "question": "What is the maximum file size for uploads?",
        "ground_truth": "25 MB per file on the free plan, 200 MB on paid plans.",
        "source_doc": "upload_limits.md",
        "category": "single_fact",
    },
    {
        "question": "Can I cancel my subscription mid-cycle and get a refund?",
        "ground_truth": "No, cancellations take effect at the end of the billing cycle. No partial refunds.",
        "source_doc": "billing_policy.md",
        "category": "single_fact",
    },
]
Vingt à trente questions suffisent pour obtenir un véritable signal au départ. Le champ de catégorie compte plus que le nombre d’entrées, et c’est généralement là que les équipes sous-investissent le plus. Un ensemble de données constitué uniquement de recherches factuelles faciles transmettra tout et ne vous dira rien, car les recherches factuelles faciles sont le seul mode de défaillance que les systèmes RAG ont rarement. Les catégories qui méritent d’être ajoutées, dans l’ordre dans lequel elles ont tendance à intervenir dans la production :
- Multi-sauts – la réponse nécessite la combinaison de deux morceaux ou plus, c’est là que la récupération est discrètement sous-récupérée
- Aucune réponse attendue – le comportement correct est de refuser de répondre, de ne pas deviner à partir du morceau sémantiquement similaire le plus proche
- Documents contradictoires ou périmés – une ancienne et une version actuelle de la même politique existent dans le corpus, et une seule a raison
- Formulation contradictoire – la même question posée avec une terminologie différente de celle utilisée dans le document source
La troisième catégorie « Documents contradictoires ou obsolètes » est la catégorie la plus ignorée dans les ensembles d’or, et c’est aussi celle qui a tendance à produire le plus d’incidents de production à propos d’une réponse fluide, bien citée, mais entièrement construite sur un document que personne n’avait réussi à archiver. Si votre corpus accumule d’anciennes versions de choses (c’est le cas de la plupart des magasins de documents d’entreprise), votre ensemble d’évaluation doit le tester, sinon votre pipeline sera tout aussi aveugle que vos réviseurs.
Effectuer une simple vérification manuelle avant d’automatiser
Exécutez l’ensemble d’or dans votre pipeline et lisez les réponses à côté de la vérité terrain avant de configurer un outil de notation. Cette étape est constamment ignorée car elle semble trop basique pour être un véritable travail d’ingénierie, mais elle vous indique si votre ensemble de données lui-même est solide et vous donne une idée de ce à quoi ressemble le « mauvais » dans votre système spécifique avant de faire confiance à une métrique pour le détecter à votre place.
results = []
for item in golden_set:
    answer = rag_pipeline.query(item["question"])
    results.append({
        "question": item["question"],
        "generated_answer": answer,
        "ground_truth": item["ground_truth"],
        "correct": None,  # fill in manually
    })
Cela détecte très tôt les échecs embarrassants, comme un modèle d’invite cassé, un récupérateur ne renvoyant rien, un modèle ignorant complètement le contexte, etc. L’automatisation de la notation d’un pipeline cassé vous donne simplement un nombre précis pour quelque chose qui ne serait jamais utile.
Automatisez la notation avec RAGAS
Une fois que les bases sont respectées, RAGAS vous offre un moyen rapide et reproductible d’évaluer le pipeline sur quatre dimensions sans lire chaque réponse à la main.
from ragas import evaluate
from ragas.metrics import (
    context_precision,
    context_recall,
    faithfulness,
    answer_relevancy,
)
from datasets import Dataset

eval_dataset = Dataset.from_list([
    {
        "question": item["question"],
        "answer": rag_pipeline.query(item["question"]),
        "contexts": rag_pipeline.retrieve(item["question"]),
        "ground_truth": item["ground_truth"],
    }
    for item in golden_set
])

result = evaluate(
    eval_dataset,
    metrics=[context_precision, context_recall, faithfulness, answer_relevancy],
)
print(result)- Précision du contexte – parmi les fragments récupérés, combien étaient réellement pertinents, pénalisant le bruit
- Rappel de contexte – estime si la récupération a capturé les informations nécessaires pour produire la réponse de référence
- Fidélité – la réponse est-elle fondée sur ce qui a été récupéré, attrapant une hallucination
- Pertinence de la réponse – la réponse répond-elle à la question réelle, et non à une question proche
Une exécution typique ressemble à ceci (les chiffres servent à expliquer chaque métrique) :
| Métrique | Score |
|---|---|
| Précision du contexte | 0,81 |
| Rappel de contexte | 0,74 |
| Fidélité | 0,88 |
| Pertinence de la réponse | 0,85 |
Un score de fidélité élevé est lu comme « la réponse est correcte », et c’est exactement la mauvaise lecture qui laisse passer les mauvaises réponses. La fidélité vérifie uniquement si la réponse est prise en charge ou non par le contexte récupéré, elle ne dit pas si ce contexte était la bonne chose à récupérer. Un document périmé ou obsolète, fidèlement résumé, produit une réponse à la fois pleinement fondée et totalement fausse. C’est le plafond structurel de RAGAS : il est très efficace pour détecter les hallucinations et très mauvais pour détecter une source erronée en toute confiance.
Ajout d’un juge LLM personnalisé pour ce que RAGAS ne peut pas vérifier
La plupart des métriques RAGAS reposent sur une évaluation basée sur LLM à l’aide d’invites prédéfinies qui ne savent rien de votre domaine. Si l’exactitude pour vous dépend de quelque chose de spécifique comme des chiffres exacts, la récence de la source, une clause de non-responsabilité requise, le ton, etc., les invites par défaut ne le capteront pas, car il n’a jamais été demandé de le faire.
Pour résoudre ce problème, vous pouvez utiliser un LLM comme juge et lui transmettre une invite personnalisée qui lui demande de juger les réponses en fonction de vos besoins spécifiques.
import json
from google import genai
from google.genai.types import GenerateContentConfig

client = genai.Client(
    vertexai=True,
    project="YOUR_GCP_PROJECT_ID",
    location="us-central1",
)

JUDGE_PROMPT = """
Compare the generated answer to the ground truth. Score 1-5 on each dimension.

Question: {question}
Ground Truth: {ground_truth}
Generated Answer: {answer}
Source Document Date: {doc_date}

1. numeric_accuracy - are all numbers and facts correct, not just plausible?
2. recency_awareness - if the source is outdated, does the answer flag
   uncertainty instead of stating it as current fact?

Return JSON only:
{{
    "numeric_accuracy": int,
    "recency_awareness": int,
    "reasoning": str
}}
"""

def custom_judge(question, ground_truth, answer, doc_date, client):
    prompt = JUDGE_PROMPT.format(
        question=question,
        ground_truth=ground_truth,
        answer=answer,
        doc_date=doc_date,
    )

    response = client.models.generate_content(
        model="gemini-2.5-flash",
        contents=prompt,
        config=GenerateContentConfig(
            temperature=0,
            max_output_tokens=250,
            response_mime_type="application/json",
        ),
    )

    return json.loads(response.text)
N’exécutez pas cette opération sur l’ensemble de données complet à chaque fois, car elle est plus lente et coûte plus cher par appel que RAGAS. Étendez-le aux catégories pour lesquelles l’évaluation RAGAS est réellement limitée, ce qui signifie en pratique conflicting_docs et no_answer_expected. L’exécuter partout ailleurs, c’est payer pour une précision dont vous n’avez pas besoin sur des questions. RAGAS obtient déjà des résultats fiables.
Utiliser un humain dans la boucle
RAGAS et un juge personnalisé sont toujours des LLM marquant le résultat d’un autre LLM, et ils ne seront pas toujours d’accord avec un humain. Le chiffre honnête à connaître ici, que la plupart des équipes ne mesurent jamais, est la fréquence à laquelle votre juge est réellement d’accord avec une personne. Dans la pratique, un accord LLM-juge-humain de l’ordre de 80 % est courant, ce n’est pas un signe que quelque chose est brisé, mais un véritable plafond mérite d’être connu plutôt que de supposer.
def needs_human_review(ragas_score, judge_score, threshold=1.0):
    return abs(ragas_score - judge_score) > threshold
Cela permet de garder la file d’attente d’évaluation humaine petite et ciblée, uniquement les cas où deux méthodes de notation sont en désaccord, et non toutes les réponses. Il est également utile que deux personnes obtiennent indépendamment la même poignée de réponses limites. Si les experts du domaine sont en désaccord les uns avec les autres près d’un tiers du temps sur un type de question donné, ce n’est pas un problème de pipeline de notation, la vérité terrain elle-même est ambiguë, et aucun outil ne résout ce problème. Cela signifie généralement que l’entrée de l’ensemble d’or doit être réécrite, et non le juge.
Surveillez la dérive après l’expédition du système
Un pipeline qui fonctionne uniquement sur un ensemble d’or fixe a un angle mort car le corpus actif change en dessous. De nouveaux documents sont ajoutés, les anciens sont archivés et les requêtes réelles des utilisateurs s’éloignent de celles sur lesquelles vous avez initialement testé. Rien de tout cela n’apparaît dans un ensemble de données qui a été gelé le jour où vous l’avez écrit.
import random
from datetime import datetime, timedelta

def sample_production_queries(logs, n=50, days=7):
    recent = [q for q in logs if q["timestamp"] > datetime.now() - timedelta(days=days)]
    return random.sample(recent, min(n, len(recent)))
En échantillonnant chaque semaine une petite tranche de trafic en direct et en l’exécutant grâce à la précision et à la fidélité du contexte de RAGAS, ces deux métriques fonctionnent sans réponse de vérité terrain, vous donne un deuxième signal. Une chute soudaine sans changement de code correspondant signifie généralement que quelque chose a changé dans le corpus, pas dans le pipeline, et c’est un mode d’échec différent de tout ce qu’une vérification au moment de la fusion détectera.
L’exécuter en tant que pipeline
Deux choses en font un véritable pipeline plutôt qu’un exercice ponctuel : planification adaptée aux coûtset un Porte CI.
Exécuter la pile complète : RAGAS, le juge personnalisé et l’examen humain de chaque commit sont suffisamment coûteux pour que la plupart des équipes arrêtent discrètement de le faire au bout d’un mois. La hiérarchisation fonctionne mieux dans la pratique :
- RAGAS sur l’ensemble doré complet : chaque demande de tirage touchant la récupération ou les invites
- Juge personnalisé sur les catégories signalées uniquement : chaque demande d’extraction, limitée à une poignée d’exemples
- Examen humain : hebdomadaire, dans la file d’attente des désaccords uniquement
- Échantillonnage de production : hebdomadaire, sur une tranche tournante du trafic réel
def check_regression(current_scores, baseline_scores, threshold=0.03):
    regressions = [
        (metric, baseline_scores[metric], score)
        for metric, score in current_scores.items()
        if baseline_scores[metric] - score > threshold
    ]
    if regressions:
        raise SystemExit(f"Blocking merge — regressions found: {regressions}")
    print("No regressions. Safe to merge.")
Connectez-le à CI afin qu’il s’exécute à chaque demande d’extraction touchant la récupération, le regroupement ou les invites, et laissez-le échouer la construction si une métrique dépasse votre seuil. C’est la partie la plus importante de toute la configuration, et c’est aussi celle qui prévient réellement les incidents. Par exemple, un changement groupé qui interrompt discrètement une classe de requêtes est intercepté ici, avant de devenir un ticket de support trois semaines plus tard au lieu d’un échec de vérification aujourd’hui.
Conclusion
Aucune des six étapes ci-dessus n’est impressionnante en soi lorsqu’elle est utilisée indépendamment, mais ce qui fait la différence est de les exécuter ensemble, selon un calendrier, comme quelque chose à laquelle l’équipe a confiance plutôt que comme quelque chose dont quelqu’un se souvient de temps en temps. C’est le but de cet article, depuis l’exécution de l’évaluation comme une vérification instinctive ponctuelle jusqu’à son intégration dans l’infrastructure du système RAG, assis tranquillement dans CI et captant les modifications qui auraient autrement été livrées.
Si vous partez de rien, n’essayez pas de construire les six étapes en même temps. Un ensemble de données en or avec vingt bonnes questions et un score RAGAS que vous vérifiez manuellement est déjà en avance sur la plupart des systèmes RAG en production aujourd’hui. Le reste peut être ajouté à mesure que le système et votre patience pour lire les réponses à la main grandissent.

You may also like

Comment décoder le paramètre de température dans les LLM

