
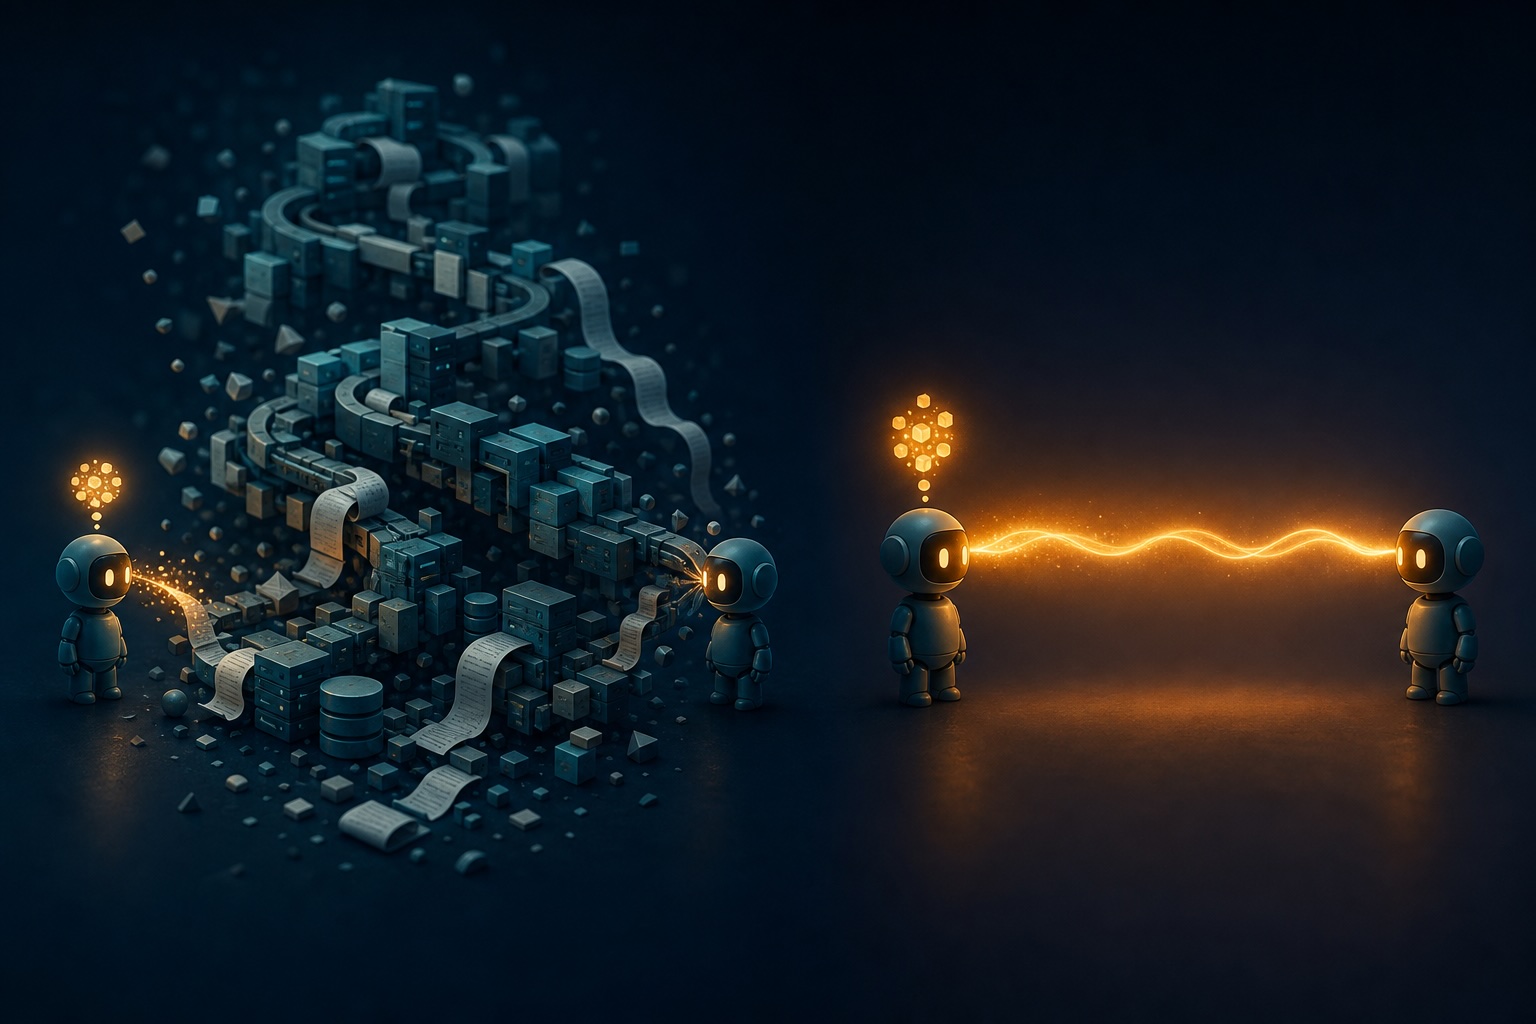
RAG a toujours été une solution de contournement temporaire. Quelle est la prochaine étape ?
1. La grande absurdité de la traduction
système RAG préféré. De très près.
Quelque part à l’intérieur de ce pipeline méticuleusement architecturé, un modèle de langage produit des états cachés riches et de grande dimension. Ces états sont compressés en une chaîne de caractères. Cette chaîne est réencodée par un différent réseau neuronal, dans un espace différent de grande dimension. Ce vecteur est stocké. Plus tard, un autre vecteur est comparé à celui-ci. Les ficelles gagnantes sont tirées, collées ensemble et remises à un troisième modèle qui reconstruit laborieusement un état caché à partir de ces personnages.
Nous avons appelé cette « mémoire ». Un nom plus honnête serait : un jeu de téléphone très élaboré et à haute latence dans lequel chaque joueur est un réseau neuronal.

La chaîne complète, dessinée clairement :
Hidden State → Generate Text → Embed Text → Store Vector → Retrieve Vector → Append Text → Recompute Hidden State
Lisez cette chaîne de flèches deux fois. Deux des sept étapes sont neuronales. Les cinq autres existent uniquement parce que nous ne pouvons pas encore conserver l’état neuronal lui-même. Nous avons donc construit toute une industrie pour le reconstruire à partir du texte chaque fois que nous en avions besoin. Bases de données vectorielles, modèles d’intégration, reclasseurs, heuristiques de segmentation, évaluateurs de récupération — tout un écosystème pour contourner une fonctionnalité manquante.
Rien de tout cela n’est une critique des ingénieurs qui l’ont construit. Compte tenu des primitives dont ils disposaient, RAG était le droite solution. Mais nous devons être honnêtes sur ce dont il s’agit : une couche de traduction à forte surcharge, pas un système de mémoire.
Ce n’est pas un argument contre RAG. C’est un argument selon lequel RAG résout un problème temporaire limitation du système plutôt que de représenter l’architecture finale de la mémoire de l’IA.
2. L’illusion de la fenêtre contextuelle
Je peux supposer sans risque que l’objection standard est désormais en train de se réchauffer dans la tête du lecteur. « Rien de tout cela n’a d’importance. Utilisez simplement une fenêtre contextuelle de deux millions de jetons et videz tout dedans. »
Objection légitime. Et non non plus.
Des fenêtres contextuelles plus grandes sont résolues capacité. Ils ne résolvent pas portabilité. Ils ne résolvent pas persistance. Et surtout, ils ne résolvent aucun de ces problèmes dans les environnements qui vont définir la prochaine décennie de l’IA appliquée.
Imaginons qu’un agent autonome confie une tâche à un autre. Ou un périphérique périphérique (par exemple, un drone, un téléphone, un robot, un nœud de réseau) se déplaçant entre des clusters de calcul. Ou un pipeline multi-agents dans lequel le routeur, l’appelant d’outil, le filtre de sécurité et le finaliseur vivent tous dans des processus différents sur des machines différentes.
Dans chacun de ces contextes, l’unité de transfert entre deux ordinateurs ne peut pratiquement pas être une invite de deux millions de jetons. Le coût de la bande passante est pénalisant. La re-tokenisation est un travail inutile. Et le récepteur doit encore relire la transcription complète – un pré-remplissage complet sur chaque jeton – pour reconstruire tout semblant de l’état de raisonnement de l’expéditeur. Même sur du matériel moderne, cette opération n’est pas gratuite. C’est exactement le problème d’origine, habillé d’une fenêtre contextuelle plus grande.
Un contexte plus large est un meilleur livre. Ce n’est pas une façon de téléporter votre dernière pensée.
3. La réalité de l’ingénieur système (budgets de latence)
L’ingénierie rapide s’arrête à « le modèle donne-t-il la bonne réponse ? »
L’ingénierie des systèmes commence à « … et à quelle milliseconde ? »
Vous trouverez ci-dessous un budget de latence approximatif et illustratif pour un seul appel RAG. C’est le genre de texte que vous griffonnez la première fois que votre accord de niveau de service en matière de latence cesse d’être généreux :
| Étape | Latence illustrative (ms) |
|---|---|
| Génération de jetons (en amont) | 15 |
| Intégration | 12 |
| E/S réseau | 8 |
| Recherche de vecteurs | 25 |
| Reclassement | 10 |
| Reconstruction rapide | 15 |
| Décodage | 50 |
| Total | ≈ 135 ms |
Ce sont blocage, séquentiel opérations. Vous ne pouvez pas commencer le décodage tant que l’invite n’a pas été reconstruite. Vous ne pouvez pas reconstruire l’invite tant que le saut de réseau et la recherche de vecteurs ne sont pas revenus. Chaque milliseconde dans cette colonne doit attendre la fin de la précédente.
Dans un chatbot, 135 millisecondes sont invisibles. Personne ne se plaint.
Dans une boucle de contrôle robotique continue, un système de retour haptique, une pile autonome ou un transfert de station de base sans fil entre nœuds d’accès radio, 135 millisecondes ne sont pas suffisantes. dans le budget. Il est le budget, entièrement consacré à la plomberie, avant que le modèle n’ait dit quoi que ce soit d’utile.
C’est là que la fonction de forçage cesse d’être académique. Le transfert direct de GPU à GPU d’un état latent ignore l’étape d’intégration, le saut de réseau vers un magasin de vecteurs, la requête de récupération, le reclassement et la reconstruction rapide. Vous n’accélérez pas chaque étape individuelle. Vous les supprimez du pipeline. Dans les domaines où chaque milliseconde est déjà prise en compte, c’est le seul type d’« accélération » qui compte réellement.
4. L’arc évolutif de la mémoire
Ce n’est pas la première fois que le domaine creuse une couche de traduction. En gros, c’est le cinquième.

Chaque étape de ce graphique était autrefois la fin du jeu pour quelqu’un. Aucun d’entre eux n’est resté jusqu’à la fin du match.
Raw Files → Relational DBs → Search Indices → Text Embeddings → Vector Search → Latent Persistence
Chaque étape de cette chaîne a résolu le problème de récupération à un niveau d’abstraction plus élevé que le précédent, et chaque étape a finalement cessé d’être l’interface principale. Les bases de données relationnelles n’ont pas disparu : elles sont devenues discrètement la couche de stockage située sous tout le reste. Les indices de recherche n’ont pas disparu : ils sont devenus une fonctionnalité au sein de plates-formes plus grandes. Les intégrations de texte n’ont pas disparu : elles ont permis l’ère de la recherche vectorielle. Chaque couche continue de vivre. Ce n’est plus le lieu où de nouvelles applications sont créées.
La recherche de vecteurs est exceptionnelle dans ce pour quoi elle a été conçue : recherche de documents d’entreprise, graphiques de connaissances sémantiques, récupération de séquences biologiques, découverte de code, recommandation. Cela ne disparaîtra pas. Ce qui est susceptible de changer, c’est son rôle en tant que mécanisme de mémoire conversationnelle par défaut pour les systèmes d’IA. Ce rôle est un pont temporaire, maintenu par le fait que les modèles ne pouvaient pas encore conserver nativement leur propre état.
Chaque « pont temporaire » précédent de cette chaîne a finalement cessé d’être l’interface principale. Il n’y a aucune raison évidente pour que celui-ci soit différent.
5. La réalité de la mise en œuvre
Rien de tout cela ne signifie que « simplement conserver l’état latent » n’est pas facile. En fait, c’est incroyablement difficile.
Contrairement au texte, qui est un format d’échange stable, universel et standardisé, indépendant du modèle, les représentations latentes sont spécifique au modèle et souvent instable dans toutes les architectures. Ce simple fait fait de l’interopérabilité le défi central de la recherche et non un détail secondaire résolu.
L’injection directe de mémoire n’est pas un appel API que vous ajoutez négligemment à votre pile. Pour déplacer un état neuronal actif entre deux modèles, vous devez vous occuper de plusieurs détails désagréables à la fois :
- Compatibilité architecturale. Nombre de couches, dimensions cachées, dispositions d’attention, formats de cache KV : ils doivent s’aligner.
- Correspondance de précision. Envoyez un état fp16 dans un modèle bf16 et les chiffres dérivent subtilement au début, puis moins subtilement.
- Normalisation des couches et échelle résiduelle. Deux modèles avec une topologie identique peuvent toujours vivre dans des espaces cachés à des échelles différentes.
- Alignement d’intégration positionnel et rotatif. Compensations RoPE, positions absolues, comptabilité séquence-position. Si vous vous trompez, l’état transféré est décodé comme un non-sens cohérent et sûr – ce qui est sans doute le pire mode de défaillance qu’un système de mémoire puisse avoir.
C’est pourquoi « persister dans l’état caché » est resté un sujet de recherche et non un produit emballé sous film rétractable. Le contrat d’interopérabilité est Plus fort que le contrat d’interopérabilité de RAG, c’est précisément pourquoi RAG a été expédié en premier. Le texte est le protocole de secours universel car il supprime tout ce qui est difficile.
Des orientations de recherche comme Persistance du contexte latent inductif (ILCP) tenter de résoudre exactement ces alignements de protocoles – en apprenant une représentation compressée et portable de l’état côté source à une extrémité et une projection côté récepteur qui la mappe dans l’espace du modèle cible à l’autre. Des approches de cette forme sont activement explorées dans des domaines adjacents, y compris les réseaux mobiles, où la latence transférée doit survivre à un changement de station de base de réception dans un budget de temps serré inférieur à la seconde. L’état honnête de l’art, cependant, est que ces frameworks ne fonctionnent actuellement que sous compatibilité architecturale stricte – des modèles généralement identiques aux deux extrémités – et que la levée de la contrainte de compatibilité est un problème de recherche ouvert et non résolu.
C’est une affirmation beaucoup plus étroite que « les bases de données vectorielles sont mortes ». C’est aussi un outil beaucoup plus utile.
6. Les plats à emporter
Voici la version non hyperbolique de la prédiction :
À mesure que l’état neuronal persistant mûrit, le RAG textuel deviendra de plus en plus un couche d’interopérabilité plutôt que le mécanisme de mémoire primaire pour les agents IA.
La récupération de texte continuera à faire le travail pour lequel elle est vraiment excellente : se situer à la frontière où une machine doit s’expliquer à une autre machine qui ne partage pas son architecture, ou à un humain. C’est le réel force de la pile RAG, et cela ne mène nulle part.
Ce qui disparaîtra, c’est l’hypothèse selon laquelle la seule façon pour un système d’IA de transmettre de la mémoire à un autre système d’IA est de passer par une chaîne de caractères. Cette hypothèse était raisonnable il y a cinq ans. Cela devient de moins en moins raisonnable chaque trimestre.
RAG n’a jamais été la destination. C’est la solution de contournement que nous avons tous construite en attendant la réalité.
Pendant des décennies, les ordinateurs ont stocké les connaissances sous forme de symboles. AI a brièvement fait de même. La prochaine génération de systèmes d’IA pourrait enfin commencer à se souvenir de la façon dont les réseaux neuronaux pensent, et non de la façon dont les humains écrivent.
Avertissement : Les illustrations de cet article ont été générées à l’aide de l’IA (Claude Opus 4.8). Ils sont illustratifs et non photographiques, et toutes les étiquettes visibles à l’intérieur des images sont stylisées plutôt que faisant autorité – reportez-vous au corps de l’article et au code lui-même pour les noms de fonctions précis, les valeurs métriques et les détails de l’architecture.

You may also like

Comment décoder le paramètre de température dans les LLM

