
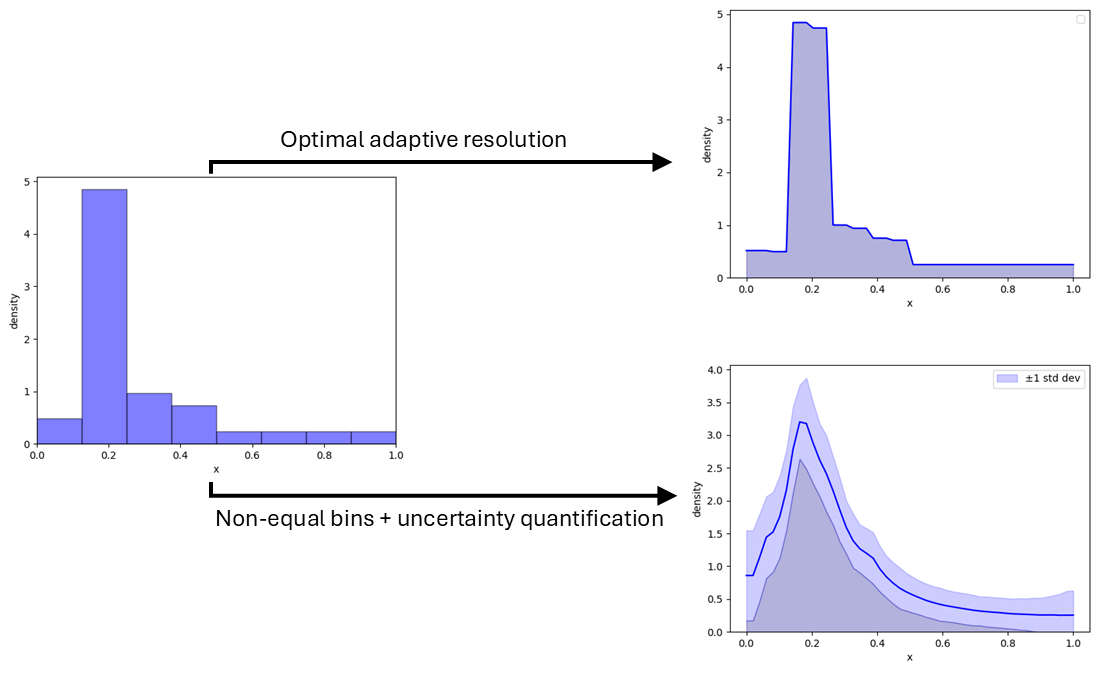
Comment choisir mathématiquement les compartiments optimaux pour votre histogramme
Vous êtes-vous déjà demandé comment choisir vos bacs dans un histogramme ? Vous êtes-vous déjà demandé s’il y avait des raisons plus profondes pour faire des choix qui vont au-delà du simple aspect esthétique ? Bien que les histogrammes constituent l’outil le plus fondamental pour la visualisation des données, il est important de définir leur résolution, en particulier lorsque l’histogramme lui-même est utilisé pour des analyses plus approfondies. Les histogrammes sont souvent calculés pour visualiser la densité des données. Dans cet article, nous explorons les mathématiques de l’ajustement de densité, en examinant spécifiquement comment les groupes devraient rétrécir à mesure que notre ensemble de données grandit. Inspiré par des domaines adjacents tels que la théorie des perturbations en physique et les développements de Taylor en mathématiques, nous trouverons une méthode rigoureuse pour construire des densités.
Toutes les images sont de l’auteur
Arrière-plan
Approximations
L’intuition est simple : plus vous disposez de données, plus vous devriez pouvoir voir de détails. Si vous examinez un échantillon de dix observations, deux ou trois cases larges sont probablement tout ce que vous pouvez vous permettre avant que votre visualisation ne devienne une collection clairsemée d’espaces vides. Mais si vous avez dix millions d’observations, ces larges cases commencent à ressembler à une photographie pixélisée à basse résolution. Vous souhaitez « zoomer » en augmentant le nombre de bacs. La question, cependant, est la suivante : comment devrions-nous exactement adapter cette résolution ?
En physique, lorsque nous sommes confrontés à un système trop complexe pour être résolu avec précision, nous nous tournons souvent vers Théorie des perturbations. En électrodynamique quantique (EDQ), par exemple, nous approchons des interactions complexes en les développant en termes d’une petite constante de couplage, comme la charge électronique. e. Cette « force d’interaction » fournit une hiérarchie naturelle pour nos approximations. Mais pour un histogramme, quelle est la « charge » analogue ? Existe-t-il un paramètre fondamental qui régit l’interaction entre nos points de données discrets et la distribution sous-jacente que nous essayons d’estimer ?
Les mathématiques offrent une autre voie : la Expansion de Taylor. Si nous supposons que la fonction de densité sous-jacente est suffisamment lisse (analytique), nous pouvons la décrire localement en utilisant ses dérivées. Cela semble être une piste prometteuse, car il est possible de démontrer que les ordres supérieurs disparaissent. Même si nous souhaitons peut-être accepter une restriction aux distributions analytiques, il n’est pas clair comment cela conduit à une certaine taille de compartiment.
Alternativement, nous pourrions traiter le problème comme une extension des fonctions de base. Tout comme nous pouvons représenter une fonction continue par morceaux à l’aide d’une transformée de Fourier ou de polynômes de Legendre, nous pourrions considérer les compartiments d’histogramme comme un ensemble de fonctions de base. En utilisant une telle approche, nous pourrions approximer la fonction en termes de L2. Mais cette approche introduit son propre ensemble d’obstacles. Comment calculer efficacement les coefficients de ces fonctions ? Et plus important encore, comment satisfaire les contraintes physiques d’une fonction de densité de probabilité ? Contrairement à une série de Fourier générale, une fonction de densité doit être strictement définie positivement et normalisée à un. Nous verrons dans la suite que la méthode issue de la théorie de l’information présente des aspects similaires à l’expansion des fonctions de base.
Théorie de l’information
Antérieurs et Postérieurs
Pour une introduction aux statistiques bayésiennes ou à la théorie de l’information, le lecteur est invité à se référer à (Murphy, 2022). Dans une approche bayésienne, un modèle où X sont les observables que nous voulons modéliser et sont nos paramètres, contient également une distribution a priori 𝑃(𝜃|ℳ) qui reflète notre croyance sur la distribution avant que les données ne soient observées. Une fois les données observées, nous pouvons estimer la distribution a posteriori
𝑃(𝜃|𝑋) = 𝑃(𝑋|𝜃)𝑃(𝜃|ℳ)/𝑃(𝑋)
Cette procédure est mathématiquement élégante car elle est 100 % sûre contre le surapprentissage. Cependant, cela exige une discipline stricte : nous ne sommes pas autorisés à choisir notre modèle ou notre a priori après avoir vu les données. Si nous utilisons les données pour décider quelle structure de modèle utiliser, nous brisons la logique sous-jacente de l’inférence.
Le modèle le plus probable compte tenu de la pondération des données par rapport au modèle
La qualité d’un modèle peut être calculée en considérant sa surprise (voir par exemple (Vries, 2026))
log 𝑃(𝑋|ℳ) = −surprise = précision – complexité
Les modèles avec un nombre excessif de paramètres (car on peut être tenté d’inclure toutes sortes d’interactions hypothétiques) peuvent atteindre une précision incroyable, mais ils sont « tués » par la pénalité de leur propre complexité. Le modèle idéal n’est pas le plus détaillé ; c’est celui qui capture le plus d’informations avec le moins de bagages inutiles.
Lorsqu’on considère un ensemble de modèles, on peut calculer la vraisemblance de chaque modèle par rapport aux modèles considérés.
𝑃(ℳ𝑖 ∣ 𝑋) ~ 𝑃(𝑋 | ℳ𝑖) 𝑃(ℳ𝑖 )
Il est tentant de simplement choisir le modèle présentant la probabilité la plus élevée et de passer à autre chose. Mais cette approche du « gagnant rafle tout » comporte des risques :
- Fluctuations statistiques : les données 𝑋 peuvent contenir un hasard aléatoire qui donne à un modèle sous-optimal une apparence temporairement supérieure.
- Le poids de la foule : Parfois, la somme de nombreux modèles « moins probables » dépasse en fait la probabilité du « meilleur » modèle unique.
Pour cette raison, une voie plus robuste consiste à poursuivre tous les modèles, en les pondérant en fonction de leur probabilité. Il est important de noter qu’il ne s’agit pas d’un « mélange » de différentes vérités ; nous supposons toujours qu’un seul modèle est réellement vrai, mais nous utilisons la distribution complète des possibilités pour tenir compte de notre propre incertitude.
Densités
Une densité utilisant une approche bayésienne
Pour traiter une densité comme un modèle formel, nous considérons chacune de ses classes 𝐾 comme un paramètre. Plus précisément, nous attribuons un poids à chaque compartiment, représentant la probabilité qu’un point de données tombe dans cet intervalle. Parce que la probabilité totale doit totaliser un (), une densité avec 𝐾 cases est définie par 𝐾 −1 paramètres indépendants, de tels modèles sont également appelés mélanges. Dans notre cadre bayésien, nous devons attribuer un avant à ces poids. Étant donné que nous avons affaire à des proportions catégorielles dont la somme doit être égale à un, la distribution de Dirichlet est le choix mathématiquement naturel.
Choisir les hyperparamètres
La distribution de Dirichlet est régie par des hyperparamètres, souvent notés 𝛼. Ces valeurs représentent nos « pseudo-comptes » – essentiellement ce à quoi nous pensons que la densité ressemble avant
J’ai même vu le premier point de données. Lorsque nous supposons un a priori plat (où la preuve 𝑃(𝑋) est constante), deux stratégies principales émergent pour choisir 𝛼 :
- 𝛼 =1/𝐾 (Le choix clairsemé) : Ceci est souvent utilisé lorsque nous nous attendons à ce que les données soient très concentrées. Il suppose a priori que la majorité des bacs seront vides, ce qui en fait un a priori « favorisant la rareté ».
- 𝛼 = 1 (Le choix uniforme) : Également connu sous le nom d’a priori plat ou de Laplace, cela suppose que chaque distribution possible de poids est équiprobable. Il ajoute essentiellement une observation « virtuelle » à chaque bac avant l’arrivée des données réelles.
Afin de construire une densité standard, le deuxième choix 𝛼 = 1 est souvent le plus naturel. Cela reflète un point de départ neutre où nous supposons que les données sont uniformément réparties sur l’intervalle jusqu’à ce que les preuves prouvent le contraire.
En définissant ainsi nos bins, nous avons transformé la « pixellisation » d’une densité en un modèle rigoureux. Nous avons maintenant un ensemble fixe de paramètres (𝐾 − 1 poids) et un a priori clair (𝛼 = 1). L’étape suivante consiste à utiliser les données pour déterminer le nombre optimal de cases 𝐾 en équilibrant la précision de l’ajustement et la complexité des paramètres.
Exemple
Veuillez regarder les données dans la figure ci-dessous :

En équipant 8 bacs on obtient :

Ce que l’on peut voir dans cette densité, c’est que le bac le plus à droite est au-dessus de zéro bien qu’aucun point de données n’était présent dans ce bac. Ceci est le résultat de l’approche bayésienne qui estime la densité estimée sur la base de nos croyances antérieures et des données que nous avons observées.
En résumé, nous avons obtenu une densité en utilisant une approche bayésienne. Nous avons défini un a priori 𝑃(𝜃) qui reflète notre attente d’une densité uniforme. Ensuite, nous avons pris les données et calculé la valeur postérieure 𝑃(𝜃|𝑋) qui sous-tend la densité résultante.
Densités pondérées
En utilisant l’approche de la section précédente, nous pouvons créer des densités en utilisant 1, 2, 4, 8, 16, 32, 64, 128, 256, 512 et 1024 bacs. Un plus grand nombre de compartiments permet un ajustement plus précis des données, mais introduit également des complexités supplémentaires. Comme nous l’avons vu dans la section précédente, on peut utiliser l’exactitude et la complexité pour calculer ses preuves. En considérant chaque densité comme un modèle, nous pouvons calculer sa probabilité d’être vraie par rapport à l’ensemble de modèles que nous considérons. Cela donne le chiffre ci-dessous :

Dans la section précédente, il a été expliqué que l’on pouvait choisir le « meilleur » modèle, qui serait dans ce cas l’utilisation de 8 bacs. Il est cependant plus sûr de prendre une somme pondérée sur tous les modèles. Ce
donne :

Il est important de réaliser que d’un point de vue bayésien, c’est le mieux que nous puissions faire. Notez également que dans ce graphique il y a une densité présente de 1024 bacs. Enfin, on peut prouver que les densités d’ordres N supérieurs vont diminuer.
Densités avec des bacs inégaux
La densité précédemment obtenue ci-dessus semble un peu en blocs, ce qui provient du choix d’utiliser des bacs égaux. Il existe d’autres options disponibles, telles que la prise de fractionnements aléatoires (et la compensation du prior). Cela donne le graphique ci-dessous :

Densités avec barres d’erreur
Maintenant, pour clôturer la construction des densités, il peut être intéressant de visualiser notre incertitude sur ces densités. Bien que numériquement coûteuse à calculer, l’expression permettant de calculer l’écart type de la densité est remarquablement simple (F. Pijlman, 2023)
Cela donne les densités ci-dessous :


Conclusions
Nous avons commencé par une question simple : existe-t-il une base mathématique pour choisir les cases dans un histogramme ? Comme le concept de compartiments relie intrinsèquement les points de données aux densités, nous avons étudié comment
choisir des bacs en fonction des densités.
En utilisant une approche bayésienne (théorie de l’information), on peut ajuster les densités sans avoir à craindre un surajustement (trop de compartiments montrant trop de détails). Bien que l’on puisse calculer la « meilleure » largeur de bac, nous avons vu que :
- La pondération du modèle nous permet de combiner plusieurs résolutions, offrant ainsi une représentation plus fluide et plus honnête des données.
- Les Dirichlet Priors nous donnent une manière rigoureuse d’exprimer nos hypothèses initiales sur la distribution des données.
Tout comme la théorie des perturbations fournit une hiérarchie pour les interactions physiques, ce cadre bayésien fournit une hiérarchie pour la résolution des données. La résolution évolue naturellement à mesure que davantage de données deviennent disponibles. Notez que de telles idées peuvent également être utilisées lors de l’apprentissage de modèles dans lesquels on a une expansion des interactions.
La méthode de combinaison de densités de différentes résolutions a également été explorée dans le cas où des compartiments aléatoires seraient choisis. Cela a conduit à des histogrammes fluides qui peuvent sembler plus naturels pour la plupart des données.
ensembles.
Nous avons également présenté l’utilisation des écarts types dans les histogrammes. Bien que le calcul des écarts types ait été dérivé des modèles bayésiens, sa procédure de calcul suggère une applicabilité plus large. En tant que tel, cela peut servir à visualiser les incertitudes restantes sur les densités.
Remerciements
Le projet EdgeAI « Edge AI Technologies for Optimized Performance Embedded Processing » a reçu un financement du Key Digital Technologies Joint Undertaking (KDT JU) dans le cadre de la convention de subvention n° 101097300. Le KDT JU reçoit le soutien du programme de recherche et d’innovation Horizon Europe de l’Union européenne et de l’Autriche, de la Belgique, de la France, de la Grèce, de l’Italie, de la Lettonie, du Luxembourg, des Pays-Bas et de la Norvège.
Références
- F. Pijlman, JL (2023). Variance de la vraisemblance des données. https://sitb2023.ulb.be/proceedings/, 34/37.
- Murphy, K. (2022). Apprentissage automatique probabiliste : une introduction. Presse du MIT.
- Vries, B.d. (2026). Inférence active pour les agents d’IA physiques. arXiv.
Biographie
Fetze Pijlman est scientifique principal chez Signify Research à Eindhoven, aux Pays-Bas. Ses recherches portent sur l’apprentissage automatique probabiliste, l’inférence bayésienne et le traitement du signal, avec un intérêt particulier pour l’application de ces cadres mathématiques à l’IoT, à la détection et aux systèmes intelligents.

You may also like

Comment décoder le paramètre de température dans les LLM

