
Du prototype au profit : résoudre le problème de la gravure de jetons agent
Cet article a été co-écrit par Rahul Vir et Reya Vir.
à l’efficacité des jetons
Nous avons officiellement dépassé la phase de prototypage de l’IA. S’appuyer sur les concepts d’Échapper au mirage prototype [1]les équipes produit et d’ingénierie de tous les secteurs proposent désormais des applications agentiques qui résolvent les flux de travail auparavant dominés par le travail manuel. Construire ces prototypes d’agents autonomes est désormais un jeu d’enfant. C’est aussi simple que d’utiliser des concepts clés tels que les boucles agentiques récursives (Observer-Think-Act) pour l’exécution, de configurer des passerelles sans tête pour connecter les agents via des applications de chat et de s’appuyer sur l’état stocké qui persiste lors des redémarrages (comme expliqué dans [1]). Mais les transformer en produits fiables est une autre histoire. La nouvelle frontière ne prouve pas que les agents peuvent travailler, mais plutôt qu’ils peuvent travailler de manière rentable.
Dans le même temps, les mesures internes des entreprises telles que le « token maxing » (utilisation sans contrainte des tokens pour obtenir les meilleurs résultats) qui étaient appropriées pour l’étape de prototypage évoluent vers la mesure du ratio « valeur/token dépensé » à mesure que les produits agents évoluent. Après tout, la plupart des produits doivent être rentables et maximiser la marge à mesure qu’ils passent de l’exploitation du calcul traditionnel bon marché (TradCompute) pour résoudre les problèmes des utilisateurs à l’utilisation de l’intelligence artificielle à cette fin.
Mais les modèles ont besoin de liberté de raisonnement et des études récentes ont montré que les flux de travail agents exploratoires surpassent les chemins fixes, ouvrant de nouveaux chemins, créant des outils MCP et construisant une infrastructure pour résoudre le problème plus efficacement dans la plupart des cas. Cela soulève la question de l’équilibre entre le besoin d’agence du modèle et la réalité économique des coûts d’inférence.
Pourquoi les agents contraints ne parviennent pas à converger
Les harnais d’agent stockent le contexte et les objectifs de votre tâche dans des fichiers markdown (*.md), qui ne représentent généralement pas des flux de travail serrés, mais décrivent plutôt l’intention ou l’objectif que vous souhaitez atteindre.
Le paradoxe de l’échec objectif : Dans des études sur des agents résolvant des problèmes complexes, les chercheurs ont découvert que le fait de fournir des lignes directrices strictes et très contraintes dans lesquelles chaque action de l’agent le rapproche de l’objectif conduit à se retrouver coincé dans un optimal local et à subir un échec objectif. Un exemple tiré des recherches du professeur Jeff Clune sur l’apprentissage ouvert des agents illustre parfaitement cela : un agent dans un labyrinthe, lorsqu’il est constamment récompensé uniquement pour avoir cherché le chemin direct vers la sortie, se cognera à plusieurs reprises contre les murs et se retrouvera piégé dans un optimum local, sans jamais atteindre la fin. [2].
La puissance des harnais sans contraintes : Les harnais d’agents contemporains comme Google Antigravity et Claude Code d’Anthropic ont été si efficaces car ils permettent aux agents de créer, d’orchestrer, d’exécuter des tâches complexes et même de créer leurs propres outils sans micro-gestion humaine stricte. Ils réussissent parce qu’ils ont la liberté d’explorer des chemins détournés.
Prenons un cas limite dans un flux de travail d’admission médicale de routine : si nous contraignons de manière rigide un agent de santé à suivre uniquement un flux de planification prédéfini, cela s’interrompt dans le monde réel. Si un patient mentionne une douleur thoracique au cours de cette prise de routine, la boucle agentique de l’agent doit avoir l’autonomie nécessaire pour reconnaître instantanément l’urgence, abandonner le flux de planification et déclencher une escalade de sécurité. Il doit utiliser ce que nous avons précédemment défini comme un « jeton de non-réponse » pour supprimer les discussions de réservation et acheminer le contexte directement vers une infirmière humaine. [1]. Les prototypes rigidement contraints échouent de façon spectaculaire à ce test car ils ne peuvent pas s’adapter à un contexte critique et hors limites.
La recherche d’objectifs infinis coûte cher
Bien qu’il soit essentiel de fournir une agence pour découvrir une solution dans un premier temps, exécuter une recherche complète et ouverte pour chaque demande de flux de travail de l’utilisateur peut conduire à une consommation massive et non durable de jetons. À ce stade, l’agent a trouvé un chemin valable et cette approche lui permet intrinsèquement de réexplorer ou « d’halluciner » la structure du flux de travail. Bien que cela puisse se corriger d’eux-mêmes, de telles exécutions ultérieures d’une requête similaire détruisent l’économie des jetons d’entreprise.
Par exemple, l’acheminement des flux de travail d’admission médicale et même les cas extrêmes qui nécessitent une escalade peuvent être appris au fil du temps. Les flux de travail d’une clinique ou d’un fournisseur de solutions évolueront pour la plupart vers des chemins déterministes, laissant une certaine autonomie réservée uniquement aux rares cas aberrants et aux cas extrêmes complexes.
Solutions architecturales grâce à un engagement précoce et une répétition déterministe
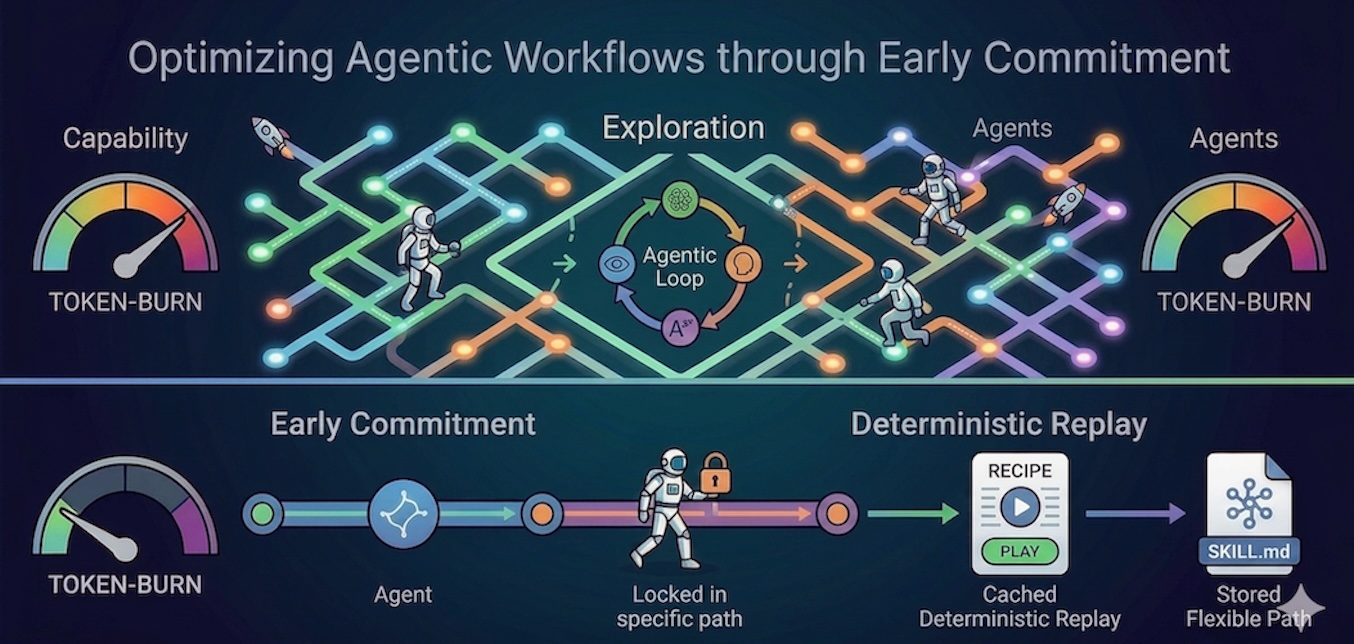
Early Commitment s’est révélé prometteur dans la résolution structurée de problèmes et peut également être appliqué aux flux de travail agents. [3]. Cela implique d’abord de classer le problème, par exemple en structurant l’invite du système pour exiger que le modèle génère une balise de classification spécifique. En forçant un agent à classer le type de problème et à établir des contraintes avant de générer la logique d’exécution, vous empêchez l’agent d’halluciner ou d’explorer des voies sans issue. Cela élimine le bruit et concentre l’agent uniquement sur l’exécution plutôt que sur l’exploration continue.
Par exemple, dans un flux de travail de triage en télésanté, nous pouvons appliquer l’engagement précoce en exigeant que l’agent classe définitivement la rencontre comme « renouvellement d’ordonnance de routine » avant de prendre toute mesure. Une fois engagé à respecter cette contrainte spécifique, l’agent limite ses appels à l’outil strictement à la base de données pharmaceutique, contournant complètement les chemins de raisonnement diagnostique coûteux et ouverts qu’il pourrait autrement emprunter pour tenter de diagnostiquer un patient.
Une étude récente de Wang, X. et al. présente le LOOP Skill Engine Framework, qui prend un engagement précoce au niveau de l’infrastructure en utilisant un paradigme d’enregistrement unique et de relecture déterministe [4]. L’agent peut explorer de manière autonome une fois en utilisant un raisonnement complet, et le système compile ensuite cette trace réussie dans une recette sans branche. Pour toutes les exécutions futures, le LLM peut être contourné, garantissant le déterminisme d’exécution et réduisant l’utilisation des jetons de plus de 93,3 % pour les tâches quotidiennes et jusqu’à 99,98 % pour les exécutions à haute fréquence. Ce concept peut être étendu aux workflows agents.
Pensez à la génération de rapports quotidiens de conformité clinique ou de résumés standard après la sortie, qui sont des tâches très stables et répétitives. En partant d’un cadre exploratoire puis en passant rapidement à un cadre déterministe, un agent doit raisonner une seule fois à travers l’extraction complexe des données du dossier de santé électronique. Pour les cent patients suivants sortis avec la même procédure, le système exécute exactement cette recette sans branchement, en échangeant de manière fiable les signes vitaux et les dates du nouveau patient sans jamais appeler le LLM. Cela garantit l’absence de données hallucinées sur les tâches répétitives de soins de santé tout en maximisant l’efficacité des jetons.
Les praticiens du ML doivent faire le choix entre une relecture déterministe pure (comme LOOP) qui maximise les économies de jetons et une approche hybride (stockage du chemin exploré dans un fichier SKILL.md). L’approche hybride échange une partie de ces économies symboliques en échange d’un raisonnement selon un chemin guidé hautement optimal, tout en laissant suffisamment de flexibilité pour s’auto-adapter à un cadre sous-jacent changeant. Que ce fichier de compétences soit mis à jour manuellement ou via un mécanisme autonome d’auto-amélioration, préserver cette marge de raisonnement garantit l’adaptabilité et la robustesse à long terme. Par exemple, si la structure de la base de données change, l’agent est capable de mettre à jour les requêtes SQL et d’extraire les informations.
Conclusion : le pipeline ML Explorer-Commit-Mesure
Les ingénieurs ML et les chefs de produit doivent adapter leurs applications pour tirer parti de la vaste intelligence des agents autonomes et adopter des harnais d’agents sans contraintes pour la découverte initiale des problèmes et les cas extrêmes complexes et ponctuels. Cela donne des solutions optimales sans exécuter un cycle d’apprentissage par renforcement coûteux (souvent bloqué par le manque d’expertise, les contraintes de la plate-forme, le coût de la formation ou les modèles fermés).
Une fois que nous avons trouvé un chemin presque optimal, l’économie des jetons pour les tâches structurées et répétitives exige que nous nous engageions dès le début dans une conception rapide, en utilisant des architectures de relecture déterministes pour mettre en cache le chemin d’exécution.
À mesure que les produits agentiques évoluent, nous devons abandonner les mesures opérationnelles des simples taux de réussite des tâches pour nous tourner plutôt vers l’efficacité des jetons et la valeur par jeton généré.
Références
- Vir, R. et Vir, R. (4 mars 2026). Échapper au mirage du prototype : pourquoi l’IA d’entreprise stagne. Vers la science des données.
- Clune, J. (12 février 2025). Conférence invitée 6 CS329A par le professeur Jeff Clune : Apprentissage ouvert des agents à l’ère des modèles de fondation [Video]. YouTube.
- Vir, R. (1er janvier 2026). Pourquoi un engagement précoce aide l’IA à résoudre des problèmes structurés. Vers l’IA.
- Wang, X., Yu, K., Liang, X., Wang, L. et Han, C. (2026). Bon à partir : le moteur de compétences LOOP qui atteint 99 % de réussite et réduit l’utilisation des jetons de 99 % via un enregistrement ponctuel et une relecture déterministe. arXiv.

You may also like

Comment décoder le paramètre de température dans les LLM

